Strings como sequências de caracteres
Entenda strings como sequências ordenadas, use índices e percursos, aplique transformações imutáveis e diferencie unidades armazenadas de caracteres percebidos.
Conteúdo 45 de 52 Skills Tecnológicas
Uma string organiza texto em uma sequência ordenada
Uma string é um valor usado para representar texto. Ela preserva uma ordem: cada unidade aparece antes ou depois de outra, e essa posição permite ler, percorrer, comparar e transformar o conteúdo.
Considere um código de atendimento:
"AX-204"
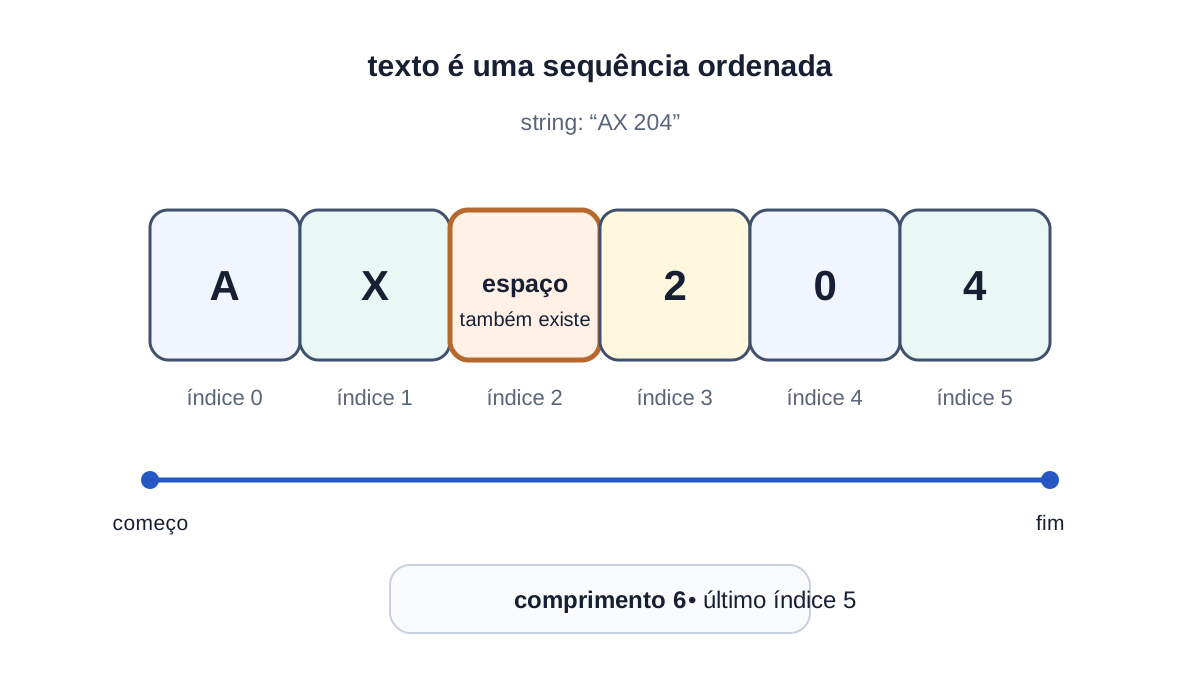
No modelo introdutório, você pode imaginá-lo como uma sequência:
A  X  -  2  0  4
0  1  2  3  4  5
O primeiro elemento está no índice 0, o hífen está no índice 2 e o último elemento está no índice 5. A string tem comprimento 6 nesse exemplo.
Esse modelo se parece com um vetor, mas uma string possui um contrato especializado para texto. Ela oferece operações como converter caixa, remover espaços nas extremidades, localizar trechos e combinar valores. Também possui regras próprias de representação que se tornam importantes com acentos, símbolos e emojis.
String, caractere, índice e comprimento não são sinônimos
Quatro conceitos aparecem juntos, mas respondem a perguntas diferentes:
- string: o valor textual completo, como
"AX-204"; - posição ou índice: o endereço de uma unidade na sequência;
- elemento acessado: a unidade devolvida naquela posição pela linguagem;
- comprimento: a quantidade de unidades contadas segundo o contrato da linguagem ou da aplicação.
Compare:
""     -> string vazia
" "    -> string com um espaço
"A"    -> string com uma letra
"A "   -> string com uma letra e um espaço final
Esses valores podem parecer semelhantes em uma tela, mas não possuem o mesmo conteúdo nem o mesmo comprimento. Quando espaços não são significativos para a regra, remova-os conscientemente com uma operação como trim; não suponha que a linguagem os ignora.
Acesse posições somente dentro do limite
Em JavaScript:
const codigo = "AX-204";

console.log(codigo[0]); // A
console.log(codigo[2]); // -
console.log(codigo[codigo.length - 1]); // 4
O contrato de um percurso indexado continua familiar:
0 <= indice < comprimento
codigo.length vale 6, mas o último índice válido é 5. Usar codigo[6] tenta ler uma posição depois do fim.
Em Python, índices e fatias permitem ler uma posição ou um intervalo:
codigo = "AX-204"

print(codigo[0])    # A
print(codigo[-1])   # 4
print(codigo[0:2])  # AX
print(codigo[3:])   # 204
A fatia codigo[0:2] começa no índice 0 e termina antes do índice 2. Essa convenção de limite final exclusivo facilita calcular o comprimento do trecho: 2 - 0 = 2.
Sintaxe e comportamento fora do limite variam. JavaScript devolve undefined em um acesso por colchetes inexistente; Python lança IndexError. O algoritmo correto não deve depender do acidente produzido por um índice inválido: proteja o acesso com o comprimento.
Percorra por valor quando a posição não fizer parte da regra
Para contar dígitos em "AX-204", basta examinar cada elemento:
const codigo = "AX-204";
let quantidadeDigitos = 0;

for (const caractere of codigo) {
  if (caractere >= "0" && caractere <= "9") {
    quantidadeDigitos += 1;
  }
}

console.log(quantidadeDigitos); // 3
Quando o índice é necessário, use um percurso controlado:
for (let indice = 0; indice < codigo.length; indice += 1) {
  console.log(indice, codigo[indice]);
}
A decisão é a mesma discutida em como percorrer um vetor: itere por valor quando importa apenas o elemento; controle o índice quando posição, vizinhança ou intervalo participam da regra.
Em Python:
for caractere in codigo:
    print(caractere)

for indice, caractere in enumerate(codigo):
    print(indice, caractere)
Evite converter uma string em array apenas para percorrê-la se a linguagem já oferece iteração textual adequada. A conversão pode mudar a unidade usada no percurso, além de criar uma coleção que não era necessária.
Strings costumam ser imutáveis
Em JavaScript, Python e C#, strings são imutáveis: depois que um valor foi criado, uma posição existente não é substituída dentro daquele mesmo valor.
Esta tentativa não altera a string em JavaScript:
let codigo = "AX-204";
codigo[0] = "B";

console.log(codigo); // AX-204
Para obter "BX-204", construa outro valor e associe-o à variável:
let codigo = "AX-204";
codigo = "B" + codigo.slice(1);

console.log(codigo); // BX-204
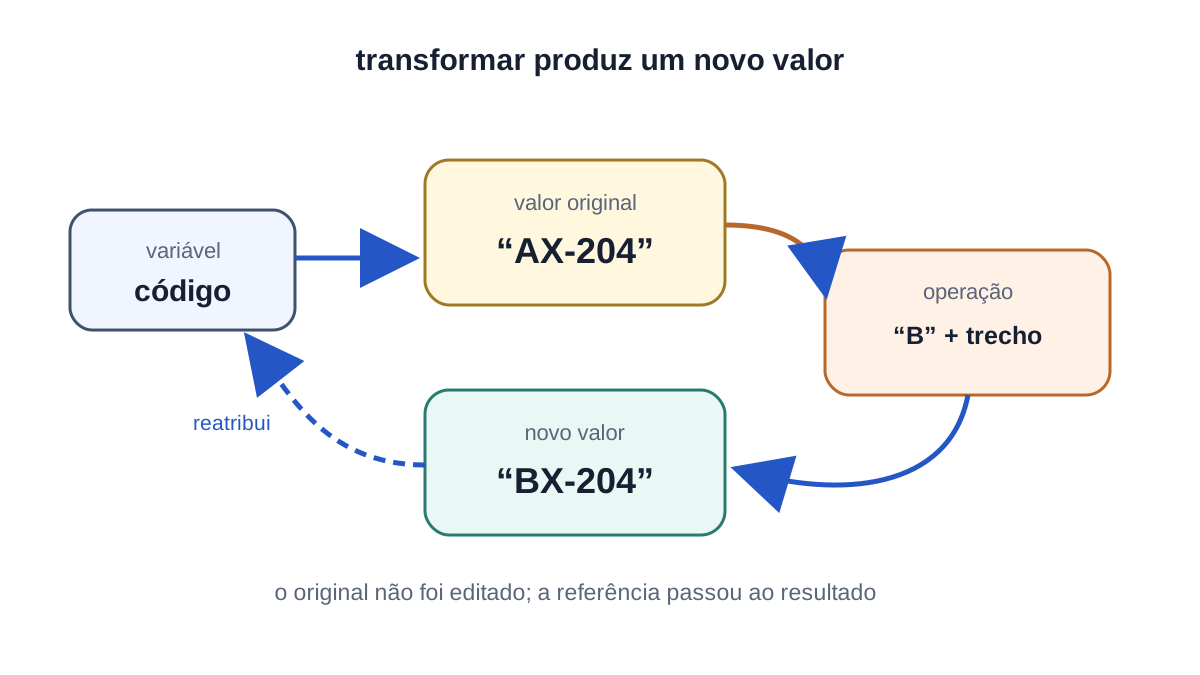
Em Python, atribuir diretamente a uma posição gera erro. A transformação também produz uma nova string:
codigo = "AX-204"
codigo = "B" + codigo[1:]
Métodos como toUpperCase, replace, trim, lower ou strip seguem o mesmo princípio: eles devolvem um resultado. Se o programa descartar esse retorno, a variável original continuará com o valor anterior.
Transforme texto em etapas com intenção clara
Dados textuais chegam frequentemente com variações previsíveis. Um fluxo simples pode:
const entrada = "  ax-204  ";
const semEspacosExternos = entrada.trim();
const normalizadoParaExibicao = semEspacosExternos.toUpperCase();

console.log(normalizadoParaExibicao); // AX-204
Cada operação tem uma responsabilidade:
trim()remove espaços apenas das extremidades;toUpperCase()produz outra representação de caixa;- a nova variável torna o resultado escolhido explícito.
Não aplique transformações automaticamente a todo texto. Espaços internos podem ser significativos; maiúsculas e minúsculas podem fazer parte de um identificador; acentos podem distinguir palavras. Primeiro defina o contrato do dado, depois escolha a transformação.
Para combinar valores, prefira recursos que expressem a estrutura:
const prefixo = "AT";
const numero = 204;
const codigo = `${prefixo}-${numero}`;
O resultado é uma nova string. A conversão de tipos deve ser consciente quando números, datas ou valores booleanos entram na composição.
Comparar strings exige definir o que significa igualdade
A igualdade exata normalmente considera a sequência armazenada:
"Admin" === "Admin" // true
"Admin" === "admin" // false
"Admin" === "Admin " // false
Antes de comparar, responda:
- maiúsculas e minúsculas devem ser diferentes?
- espaços externos são significativos?
- acentos devem ser preservados?
- a comparação serve para identificador técnico ou texto humano?
- existe uma localidade relevante para ordenar palavras?
Para um código técnico definido como maiúsculo e sem espaços externos:
function normalizarCodigo(valor) {
  return valor.trim().toUpperCase();
}

normalizarCodigo(" ax-204 ") === normalizarCodigo("AX-204"); // true
Isso funciona porque o domínio autorizou essas transformações. Não use a mesma regra para senha, texto livre ou nome próprio. Uma comparação correta depende do significado do dado, não apenas de um método disponível.
Ordenação alfabética é ainda mais sensível. Comparar valores internamente não garante a ordem que uma pessoa espera em português. Quando a tarefa for ordenar texto humano, use mecanismos de comparação sensíveis à localidade oferecidos pela plataforma.
“Um caractere” pode representar unidades diferentes
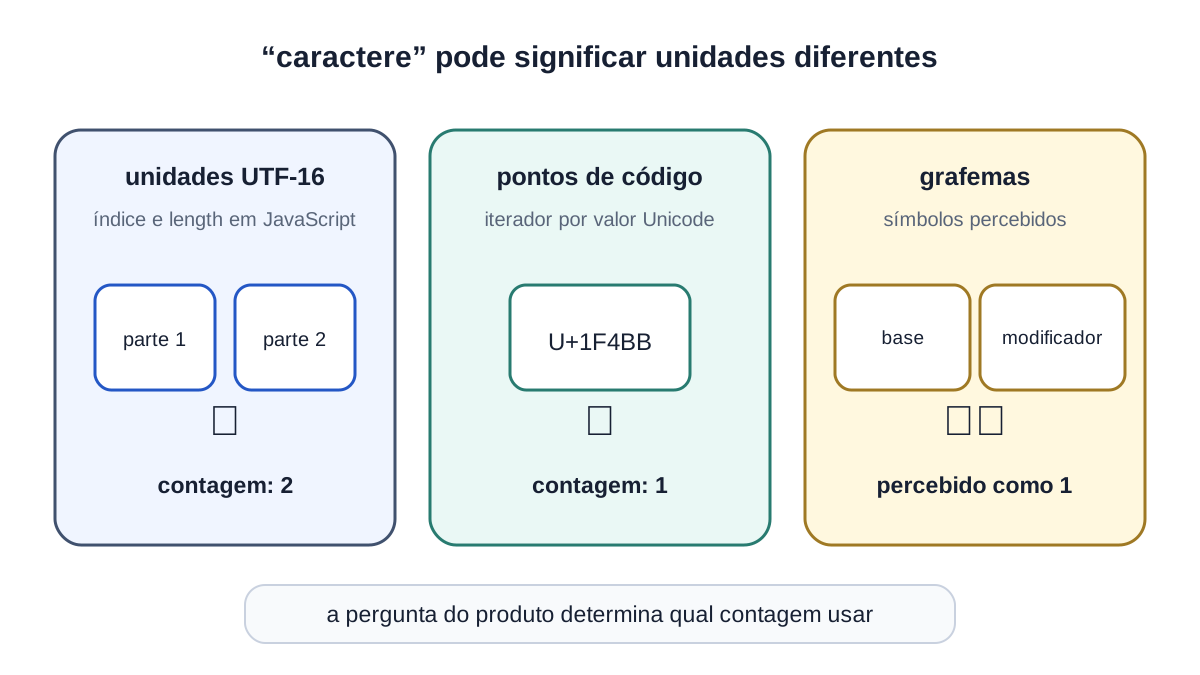
O modelo de caixas funciona bem para textos simples, mas o termo caractere pode esconder três níveis:
- unidade de código: parte usada pela codificação interna da linguagem;
- ponto de código Unicode: número atribuído a um elemento do padrão Unicode;
- grafema: aproximação do símbolo percebido como uma unidade pelo usuário.
Em JavaScript, strings são sequências de unidades UTF-16. Por isso:
"A".length;  // 1
"ç".length;  // 1
"💻".length; // 2
O emoji 💻 é um ponto de código representado por duas unidades UTF-16. O índice e length trabalham nessas unidades.
O iterador de JavaScript usado por for...of avança por pontos de código, então:
console.log([..."A💻"].length); // 2
Mas um símbolo percebido pode combinar vários pontos de código. Emojis com modificador de tom de pele ou unidos por conectores são exemplos comuns. Mesmo um percurso por pontos de código pode dividir o que a pessoa enxerga como uma unidade.
Python define str como sequência imutável de pontos de código Unicode. C# define string como sequência imutável de valores Char, e cada Char representa uma unidade UTF-16. Portanto, o mesmo texto pode produzir contagens diferentes em APIs de linguagens distintas.
Conte de acordo com a regra do produto
Não existe uma única contagem correta para todas as situações. A unidade depende da pergunta:
| Pergunta | Unidade provável |
|---|---|
| quantas posições o indexador de JavaScript acessa? | unidades UTF-16 |
| quantos pontos de código serão percorridos? | pontos de código |
| quantos símbolos a pessoa percebeu ou digitou? | grafemas |
| quantos bytes serão enviados em UTF-8? | bytes depois da codificação |
| o valor cabe em uma coluna do banco? | contrato específico do armazenamento |
Para limitar um nome a vinte símbolos percebidos, texto.length <= 20 pode ser inadequado em JavaScript. Uma API de segmentação de grafemas, como Intl.Segmenter, expressa melhor essa regra:
function contarGrafemas(texto, localidade = "pt-BR") {
  const segmentador = new Intl.Segmenter(localidade, {
    granularity: "grapheme",
  });

  return [...segmentador.segment(texto)].length;
}
Você não precisa usar segmentação avançada em todo algoritmo. Precisa apenas evitar prometer “caracteres visuais” quando a operação conta outra unidade.
Não confunda texto com bytes
Uma string é texto dentro do programa; bytes são a representação usada para armazenar ou transmitir esse texto segundo uma codificação como UTF-8.
O mesmo texto pode ocupar quantidades diferentes de bytes conforme a codificação. Por isso, cortar uma sequência de bytes em uma posição arbitrária pode quebrar a representação de um caractere. Trabalhe com strings enquanto aplica regras textuais; codifique na fronteira de arquivo, banco, rede ou protocolo.
Em Python, a distinção aparece nos tipos:
texto = "olá"
dados = texto.encode("utf-8")

print(type(texto))  # str
print(type(dados))  # bytes
Converter não significa apenas trocar o nome do tipo: encode aplica uma regra para transformar pontos de código em bytes; decode reconstrói texto a partir de bytes válidos naquela codificação.
Teste casos que parecem iguais na tela
Uma rotina textual merece casos que exponham seu contrato:
- string vazia
""; - apenas espaços
" "; - uma única letra;
- espaços internos e externos;
- letras em caixas diferentes;
- texto com acentos;
- um emoji representado por duas unidades UTF-16;
- um emoji composto por vários pontos de código;
- entrada já normalizada e entrada que precisa de transformação.
Registre três colunas no teste: entrada original, transformação aplicada e resultado esperado. Se houver limite de tamanho, escreva explicitamente se ele mede unidades da linguagem, pontos de código, grafemas ou bytes.
Pratique com identificadores e mensagens
Implemente duas regras separadas.
Para um identificador de atendimento:
- receba
" ax-204 "; - remova espaços externos;
- converta para maiúsculas;
- confirme que começa com
"AX-"; - percorra o trecho final e confirme que contém três dígitos;
- preserve o valor original para auditoria.
Para uma mensagem livre:
- preserve caixa, acentos e espaços internos;
- compare
length, quantidade de pontos de código e quantidade de grafemas para um texto com emoji; - explique qual contagem serviria para um contador exibido à pessoa;
- teste string vazia, apenas espaços e emoji composto.
O exercício está completo quando as duas rotinas não compartilham uma normalização genérica que destrói significado.
O que você deve guardar
Uma string representa texto como sequência ordenada. Isso permite acessar posições, percorrer elementos, extrair trechos, comparar e produzir transformações. Em linguagens como JavaScript, Python e C#, o valor da string é imutável: operações devolvem novos valores, e reatribuir uma variável não altera a string anterior.
O modelo simples de caracteres indexados é útil, mas não descreve todos os textos. Unidades UTF-16, pontos de código Unicode, grafemas e bytes respondem a perguntas diferentes. Defina a regra do produto antes de contar, cortar ou comparar e teste acentos, espaços e emojis quando o texto vier de pessoas reais. Para iniciar o módulo de qualidade, aprenda como identificar erros em um algoritmo por meio de evidências.
Referências
- MDN Web Docs —
String. Acesso em 22 set. 2026. - MDN Web Docs —
String.length. Acesso em 22 set. 2026. - Python 3 Documentation — Text Sequence Type:
str. Acesso em 22 set. 2026. - Python 3 Documentation — Unicode HOWTO. Acesso em 22 set. 2026.
- Microsoft Learn — Strings in C#. Acesso em 22 set. 2026.
- Unicode Standard Annex #29 — Unicode Text Segmentation. Acesso em 22 set. 2026.