Introdução à eficiência de algoritmos
Entenda como tempo e memória crescem com a entrada, conte operações e reconheça as principais classes de eficiência em algoritmos.
Conteúdo 51 de 52 Skills Tecnológicas
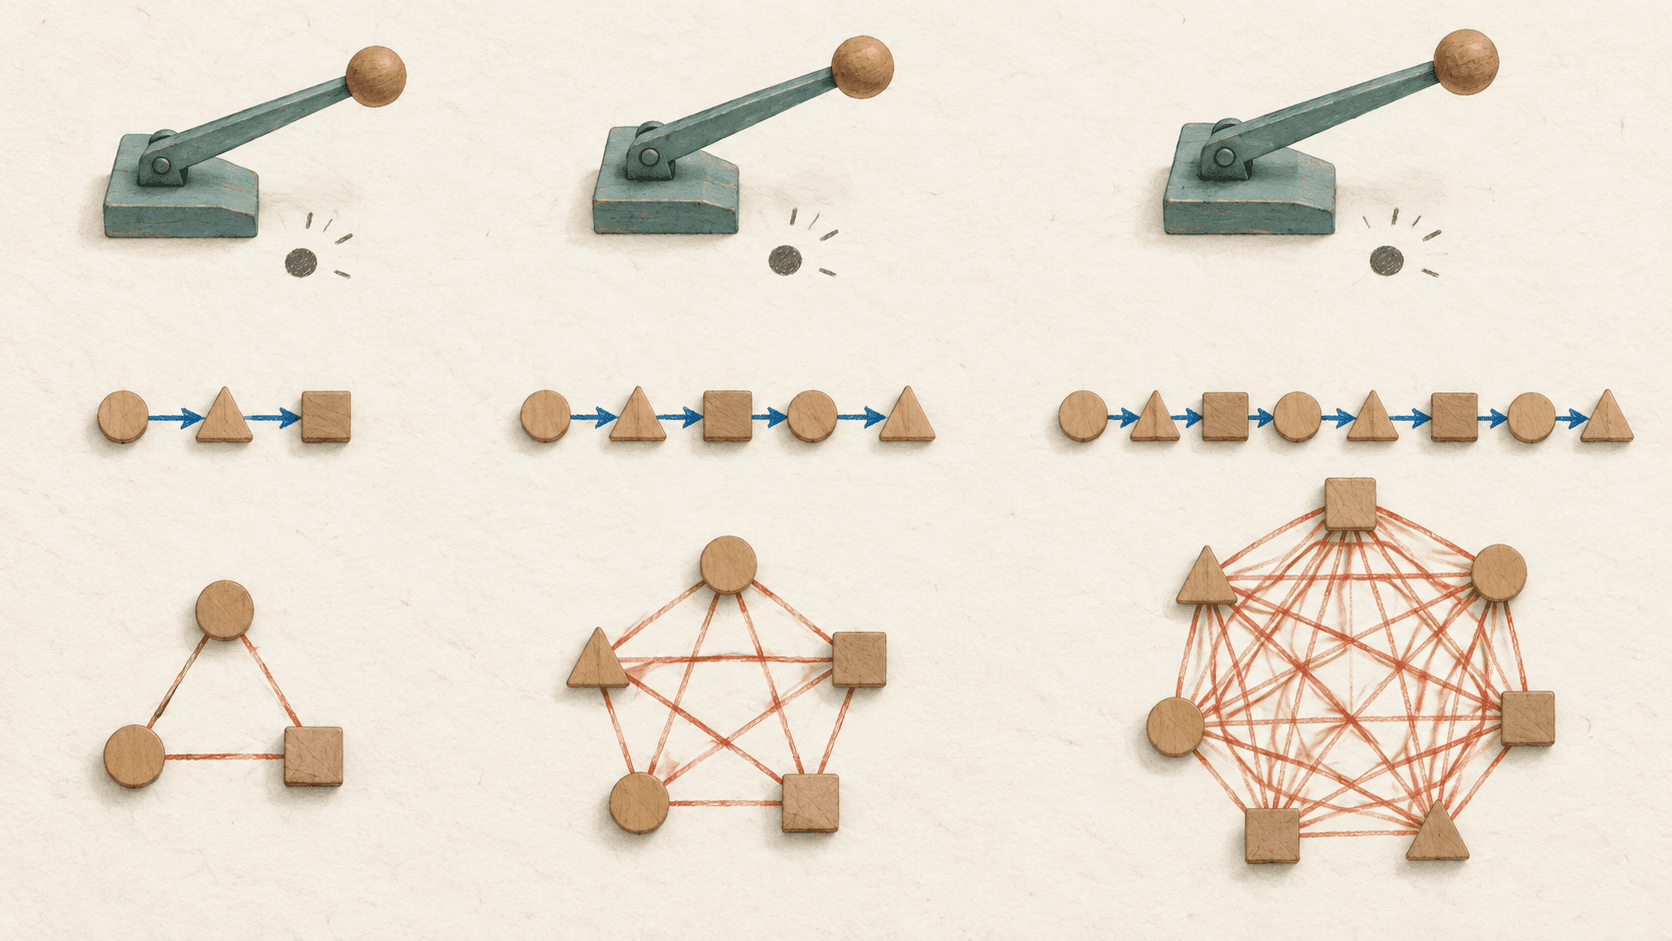
Eficiência descreve como o custo cresce
Um algoritmo eficiente não é apenas aquele que “rodou rápido no meu computador”. A pergunta mais útil é: o que acontece com o trabalho e com a memória quando o problema aumenta?
Somar dez valores é simples. Somar dez milhões exige mais operações, mas a relação continua previsível: cada novo valor acrescenta aproximadamente uma soma. Comparar todos os pares de dez valores também parece pequeno; com dez milhões, a quantidade de pares se torna impraticável.
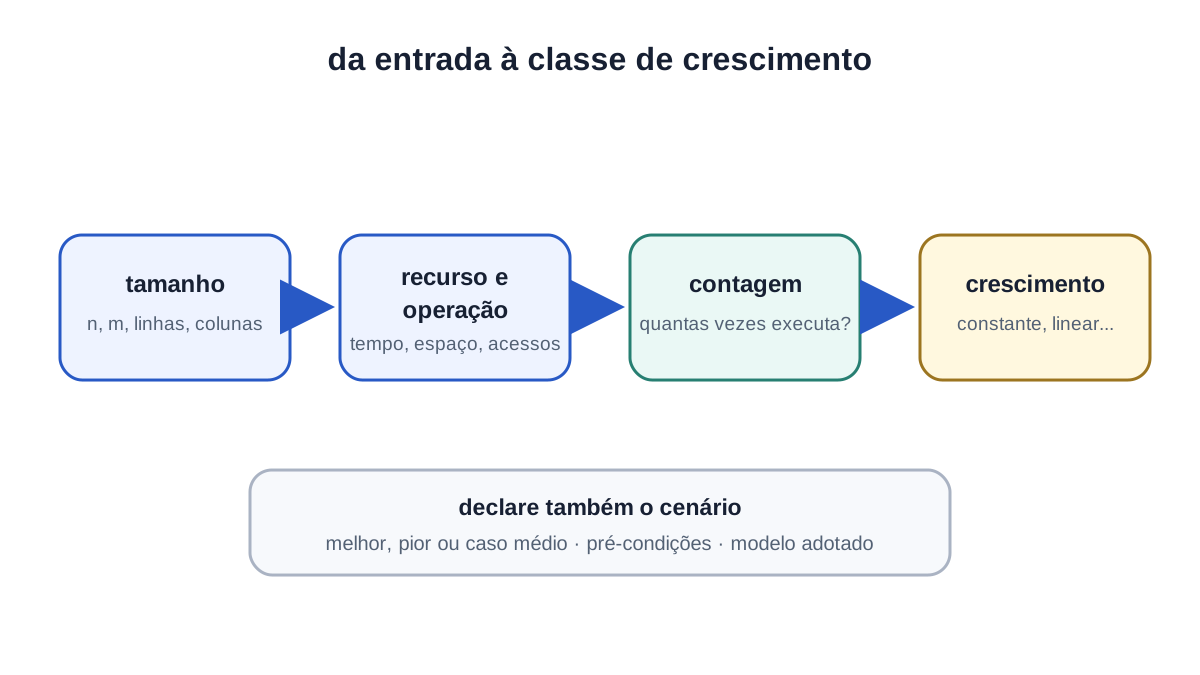
A análise de eficiência cria um modelo independente de uma máquina específica. Em vez de começar por segundos, ela relaciona:
tamanho da entrada → quantidade de operações ou memória necessária
Isso não substitui medição. O modelo explica a tendência; o benchmark verifica uma implementação em um ambiente real. E ambos vêm depois da correção: um algoritmo rápido que produz a resposta errada continua inadequado.
Na aula sobre como comparar duas soluções, contagens e medições ajudaram a justificar uma escolha. Agora vamos nomear os padrões de crescimento que estavam por trás daquela decisão.
Defina o que representa o tamanho da entrada
Usamos frequentemente n para representar o tamanho da entrada, mas n não significa sempre a mesma coisa:
- em um vetor, pode ser a quantidade de elementos;
- em uma string, pode ser a quantidade de unidades percorridas;
- em uma matriz, podem existir
llinhas eccolunas; - em um número inteiro, o tamanho formal pode ser a quantidade de bits, não o próprio valor;
- em um grafo, vértices e arestas formam dimensões diferentes.
Antes de escrever qualquer classe de eficiência, declare a variável:
n = quantidade de valores no vetor
Se um algoritmo compara duas coleções, use n e m quando os tamanhos variam independentemente. Chamar tudo de n pode transformar um custo n × m em um n² que só seria válido se as duas coleções tivessem tamanho semelhante.
Escolha um modelo de custo observável
Tempo de execução depende de processador, linguagem, compilador, sistema operacional e carga da máquina. Para estudar o algoritmo, contamos operações relevantes em um modelo simplificado:
- comparações em uma busca;
- somas em uma agregação;
- acessos a elementos;
- inserções e consultas em uma estrutura;
- chamadas recursivas;
- itens auxiliares armazenados.
O NIST ressalta que o recurso limitante depende do problema: podem importar comparações, movimentações, acessos a disco, mensagens, memória ou tempo decorrido. Portanto, “uma operação” precisa ser declarada, não presumida.
Considere a soma de um vetor:
total ← 0
para cada valor em valores:
    total ← total + valor
retorne total
Com n elementos, a soma principal executa n vezes. Inicializar e retornar acrescentam poucas operações fixas. Podemos modelar o custo como an + b, em que a e b representam detalhes do modelo.
Comece pela contagem exata
Contar antes de simplificar preserva o vínculo entre código e análise. Para este laço:
para i de 0 até n - 1:
    processe valores[i]
o bloco principal executa n vezes. Se houver dois blocos sequenciais que percorrem a coleção inteira:
para cada valor: valide valor
para cada valor: some valor
o trabalho principal é aproximadamente n + n = 2n, não n². Os laços são sequenciais.
Agora observe laços aninhados sobre a mesma coleção:
para cada a em valores:
    para cada b em valores:
        compare a com b
O bloco interno executa n vezes para cada uma das n iterações externas: n × n = n² comparações.
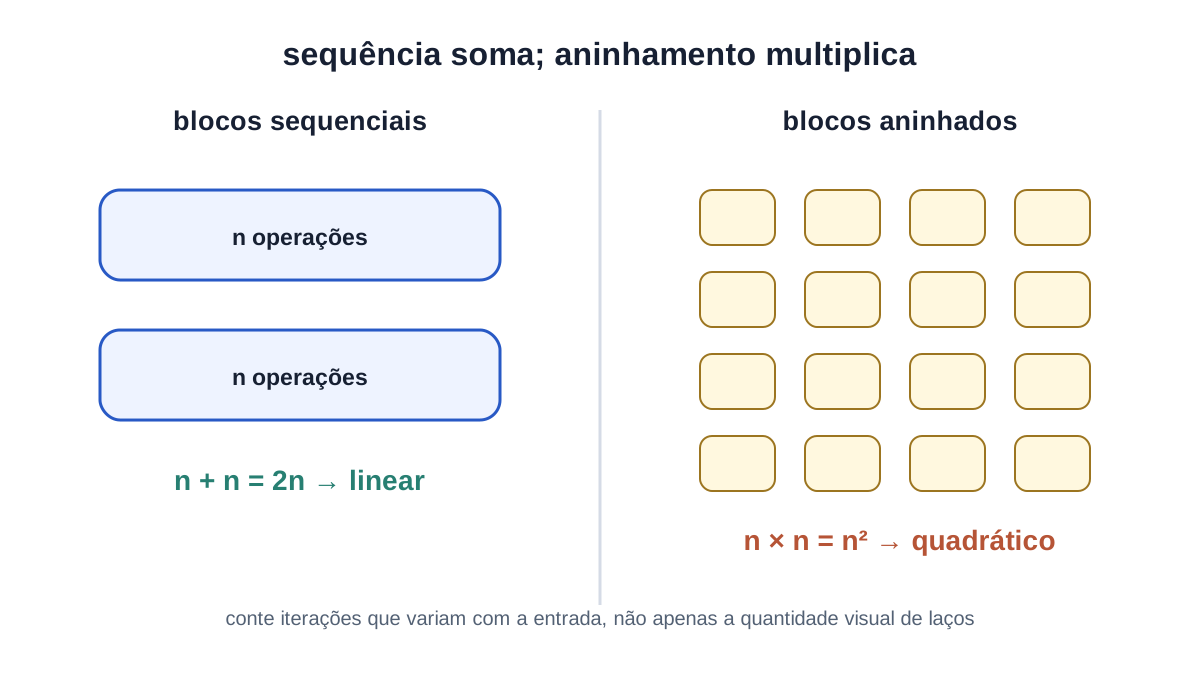
Nem todo laço aninhado é quadrático. Se o laço interno executa sempre três vezes, o custo é 3n, que continua crescendo de forma linear. Se percorre outra coleção, a expressão é n × m. A estrutura visual do código é uma pista; a contagem é a justificativa.
Observe o crescimento, não apenas um valor
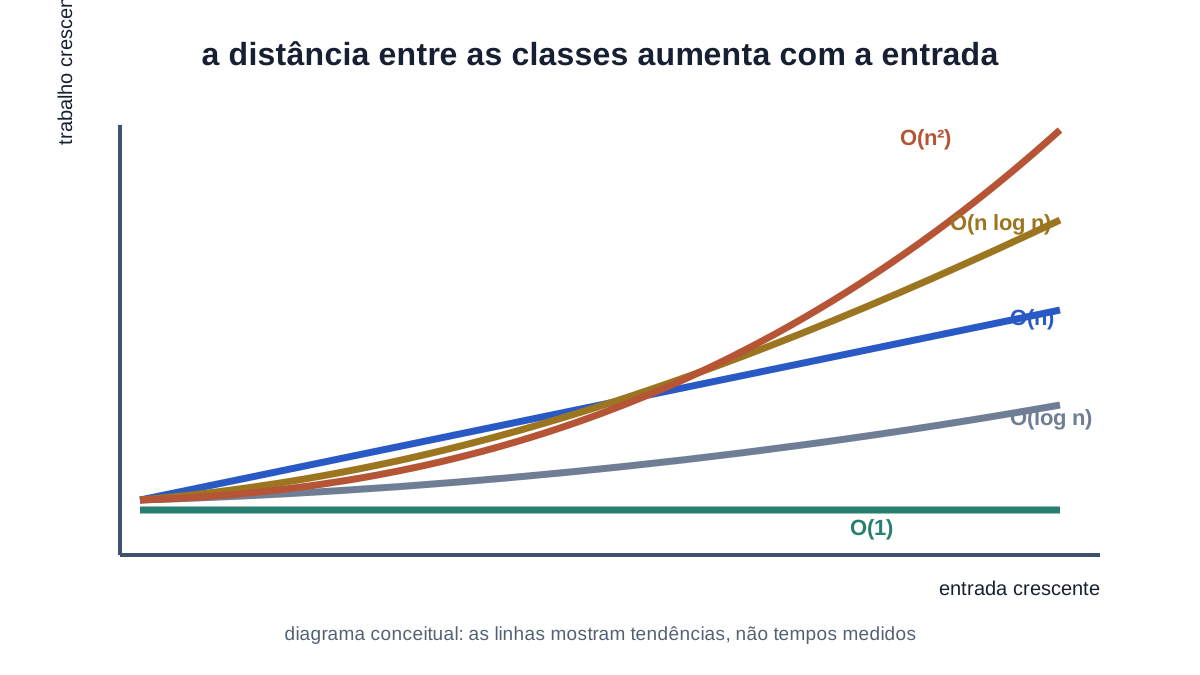
Um único tamanho pode esconder a diferença. Compare contagens aproximadas:
Entrada n | constante | log₂ n | n | n log₂ n | n² |
|---|---|---|---|---|---|
| 8 | 1 | 3 | 8 | 24 | 64 |
| 16 | 1 | 4 | 16 | 64 | 256 |
| 32 | 1 | 5 | 32 | 160 | 1.024 |
| 1.024 | 1 | 10 | 1.024 | 10.240 | 1.048.576 |
Dobrar n provoca respostas diferentes:
- o custo constante não muda;
- o logarítmico acrescenta aproximadamente um passo quando a base é dois;
- o linear dobra;
- o quadrático quadruplica;
- o exponencial pode multiplicar de forma ainda mais agressiva.
Entenda o papel da notação assintótica
A notação assintótica descreve o comportamento para valores suficientemente grandes de n. Ela abstrai diferenças fixas de máquina e detalhes que não alteram a tendência dominante.
Em sentido formal, Big O fornece um limite superior assintótico. Dizer que um custo pertence a O(n²) significa que, a partir de certo ponto, ele não cresce mais rápido que um múltiplo constante de n². Isso não quer dizer automaticamente “caso pior”, embora seja comum usar Big O para expressar um limite do pior caso quando essa condição é declarada.
Outras notações existem:
Ωexpressa limite inferior;Θexpressa um limite assintótico justo, superior e inferior.
Nesta introdução, usaremos as classes mais comuns como vocabulário de crescimento e indicaremos o cenário analisado. Quando a contagem é proporcional a n tanto por cima quanto por baixo, Θ(n) é mais preciso; em comunicação cotidiana, você também encontrará “é O(n)”.
Remova constantes e termos menos dominantes com cuidado
Se a contagem exata for:
T(n) = 3n + 7
ela cresce linearmente. Multiplicar n por três e somar sete muda valores concretos, mas não muda a forma como o custo responde a entradas cada vez maiores. Assim, a classe é Θ(n).
Para:
T(n) = n² + 5n + 20
o termo n² domina quando n cresce; a classe é Θ(n²).
Essa simplificação não autoriza ignorar tudo na prática. Um algoritmo linear com uma operação muito cara pode ser mais lento que outro para os tamanhos atuais. Constantes, cache, alocação e implementação ainda importam em medições. A notação responde sobre crescimento, não fornece sozinha o tempo final.
Reconheça o custo constante: O(1)
Uma operação é constante em relação a n quando sua quantidade de passos não cresce com o tamanho declarado:
função primeiro(valores):
    retorne valores[0]
Para uma estrutura com acesso direto por índice, buscar a primeira posição exige essencialmente o mesmo trabalho com dez ou um milhão de elementos. O(1) não significa “instantâneo”; significa “independente de n” no modelo adotado.
Também é possível executar cem operações fixas e continuar em O(1). O custo concreto é maior, mas não cresce com a entrada.
Reconheça o crescimento logarítmico: O(log n)
Um processo logarítmico reduz o problema por um fator constante a cada passo. A busca binária em uma coleção ordenada compara o alvo com o elemento central e descarta metade do intervalo:
1.024 → 512 → 256 → 128 → 64 → 32 → 16 → 8 → 4 → 2 → 1
São cerca de dez reduções para 1.024 posições. Dobrar a entrada para 2.048 acrescenta apenas uma redução.
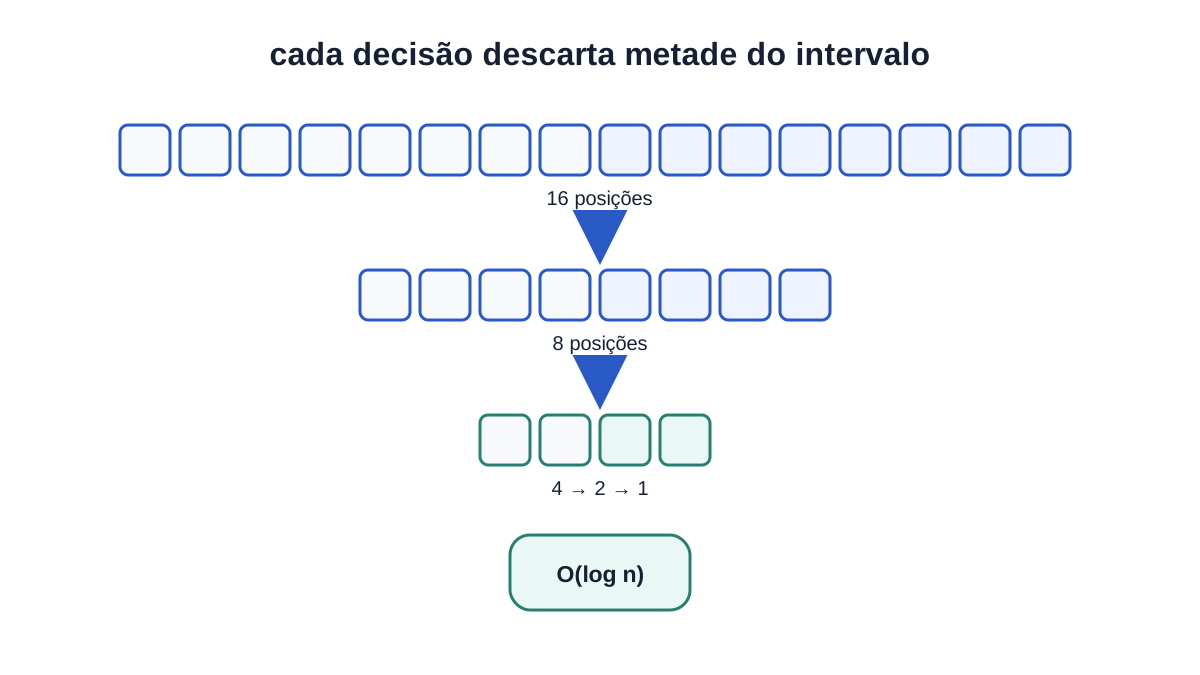
A pré-condição importa. Preparar ou manter a ordenação tem custo; busca binária não pode ser aplicada corretamente a dados arbitrariamente desordenados. O NIST define a técnica justamente pela divisão repetida de um intervalo ordenado.
Reconheça o crescimento linear: O(n)
Um algoritmo linear realiza trabalho proporcional à entrada. Somar todos os itens, encontrar o maior ou fazer uma busca que pode precisar examinar cada posição são exemplos comuns.
função contem(valores, alvo):
    para cada valor em valores:
        se valor = alvo:
            retorne verdadeiro
    retorne falso
No melhor caso, o alvo está primeiro e ocorre uma comparação. No pior caso, ele está no fim ou ausente e ocorrem n. Se declaramos o pior caso, a busca é O(n).
A aula de busca e agregação em vetores contém vários padrões lineares porque precisa observar cada elemento para produzir soma, contagem ou máximo.
Diferencie O(n log n) e O(n²)
Algoritmos n log n combinam um trabalho linear com uma quantidade logarítmica de níveis. Diversos algoritmos eficientes de ordenação por comparação apresentam essa classe em cenários específicos.
Já o crescimento quadrático aparece quando cada item se relaciona com uma quantidade proporcional de outros itens. Comparar todos os pares é o exemplo direto:
n × (n - 1) ÷ 2
Removendo constantes e o termo menor, o crescimento é Θ(n²). É o custo da solução por pares vista na aula anterior quando não existe repetição.
Ao analisar laços aninhados, pergunte quantas vezes cada nível executa em função da entrada. Não atribua O(n²) apenas por enxergar duas palavras para.
Saiba que crescimento exponencial muda a escala
Um algoritmo exponencial pode explorar combinações que dobram a cada elemento. Enumerar todos os subconjuntos de uma coleção com n itens produz 2ⁿ possibilidades:
n = 10  → 1.024 subconjuntos
n = 20  → 1.048.576 subconjuntos
n = 30  → mais de 1 bilhão
Isso não significa que todo problema combinatório deve ser abandonado. Restrições pequenas, poda, memoização, aproximação ou outra formulação podem mudar a viabilidade. O ponto introdutório é reconhecer que aumentar pouco a entrada pode multiplicar enormemente o trabalho.
Declare melhor, pior ou caso médio
O mesmo algoritmo pode executar quantidades diferentes conforme os dados. Na busca linear:
- melhor caso: alvo na primeira posição,
Θ(1); - pior caso: alvo ausente ou no fim,
Θ(n); - caso médio: depende da distribuição e das hipóteses sobre a posição do alvo.
Não escreva apenas “a busca é O(n)” quando a decisão depende do cenário. Prefira “no pior caso, a busca linear examina n elementos”.
O caso médio não é uma intuição vaga. Ele exige um modelo de probabilidade sobre as entradas. Se você não pode justificar a distribuição, use limites claros e meça dados representativos.
Analise também a memória auxiliar
Complexidade de espaço descreve como a memória necessária cresce. Diferencie:
- memória da própria entrada;
- memória auxiliar criada pelo algoritmo;
- pilha de chamadas recursivas;
- cópias, buffers e estruturas de índice.
Somar um vetor com um acumulador usa espaço auxiliar constante: Θ(1). Criar outro vetor com uma transformação para cada item usa espaço auxiliar Θ(n). Registrar valores já vistos em um conjunto também pode usar Θ(n) itens adicionais.
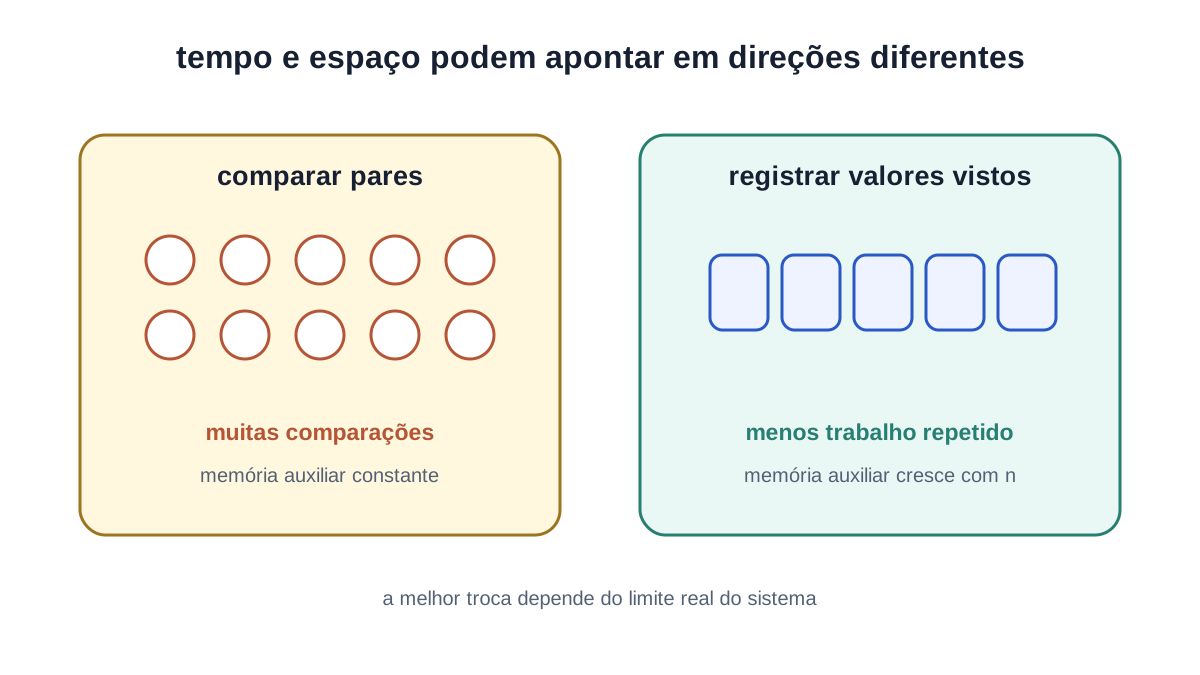
Informar somente o tempo oculta metade da decisão. Em sistemas embarcados, navegadores, dispositivos móveis ou cargas simultâneas, a memória auxiliar pode ser o limite real.
Relacione análise e medição sem confundi-las
Análise assintótica e benchmark respondem perguntas diferentes:
| Análise | Medição |
|---|---|
| como o custo tende a crescer | quanto uma implementação levou no ambiente testado |
| abstrai máquina e constantes | inclui linguagem, hardware e otimizações |
| ajuda a prever escalabilidade | confirma requisitos concretos |
| compara modelos de algoritmo | compara programas executáveis |
Use a análise para formular hipóteses e escolher tamanhos relevantes. Depois meça com várias entradas, repetições e preparação separada. A documentação do timeit alerta para interferências e oferece repetições justamente porque uma execução isolada é frágil.
Se o algoritmo O(n²) vence para n = 10, isso não invalida a análise. Pode haver constantes menores. Teste também n = 100, 1.000 e o limite esperado do produto. Observe a tendência e verifique se o requisito real é cumprido.
Use um roteiro para analisar qualquer algoritmo
Siga esta sequência:
- confirme que o algoritmo está correto;
- defina o tamanho da entrada e suas dimensões;
- escolha tempo, espaço ou outro recurso relevante;
- identifique a operação dominante;
- conte quantas vezes ela executa;
- declare melhor, pior ou caso médio;
- escreva a função de custo quando for útil;
- retenha o termo dominante para classificar o crescimento;
- registre pré-condições, como ordenação ou estrutura disponível;
- analise memória auxiliar separadamente;
- meça no ambiente-alvo quando houver requisito concreto;
- documente a troca escolhida.
Esse roteiro evita dois extremos: cronometrar sem compreender e classificar Big O sem relacioná-lo ao código.
Pratique com três algoritmos
Analise os trechos considerando n como o tamanho de valores.
A: retorne valores[n - 1]

B: para cada valor em valores:
       escreva valor

C: para cada a em valores:
       para cada b em valores:
           se a = b: conte uma relação
Para cada um:
- escolha a operação dominante;
- conte-a para
n = 4,8e16; - diga o que acontece quando
ndobra; - classifique tempo e espaço auxiliar;
- declare qualquer pré-condição;
- explique por que A não se torna linear só porque o vetor possui
nitens; - altere C para comparar itens de vetores com tamanhos
neme reescreva o custo; - proponha uma medição que não inclua a criação dos dados.
A resposta está bem fundamentada quando outra pessoa consegue ligar a classe à contagem, e não apenas ao formato visual do código.
O que você deve guardar
Eficiência é uma relação entre tamanho de entrada e recurso consumido. Declare n, escolha a operação dominante, conte o trabalho e só então use uma classe de crescimento. Sequências somam custos; aninhamentos multiplicam as iterações que realmente variam.
Big O expressa um limite superior assintótico, enquanto Θ descreve um limite justo. Constantes e termos menores podem ser abstraídos para estudar crescimento, mas continuam relevantes no desempenho concreto. Analise tempo e espaço, declare o cenário e combine o modelo com medições responsáveis.
Agora aplique esse roteiro no projeto final: da descrição do problema ao algoritmo, reunindo requisitos, representação, dados, controle de fluxo, funções, testes e análise de eficiência em uma entrega completa.
Referências
- MIT OpenCourseWare — 6.006 Introduction to Algorithms, Lecture 1. Acesso em 22 set. 2026.
- MIT OpenCourseWare — 6.006 Recitation 1: Asymptotic Notation. Acesso em 22 set. 2026.
- MIT OpenCourseWare — 6.100L Lecture 22: Big Oh and Theta. Acesso em 22 set. 2026.
- NIST — Complexity. Acesso em 22 set. 2026.
- NIST — Binary search. Acesso em 22 set. 2026.
- ISO — ISO/IEC 25010:2023 Product quality model. Acesso em 22 set. 2026.
- Python Documentation —
timeit: Measure execution time of small code snippets. Acesso em 22 set. 2026.