Como identificar erros em um algoritmo
Aprenda a reproduzir uma falha, separar erros de interpretação, lógica e implementação, localizar a primeira divergência e validar a correção.
Conteúdo 46 de 52 Skills Tecnológicas
Identificar um erro começa por definir o comportamento correto
Um algoritmo tem um erro quando seu comportamento difere do contrato esperado para uma determinada entrada. Sem uma expectativa verificável, existe apenas surpresa — não existe ainda uma falha bem definida.
Considere a regra:
Pedidos com valor acima de R$ 100 recebem 10% de desconto. Pedidos de até R$ 100 mantêm o valor original.
Uma implementação em JavaScript foi escrita assim:
function calcularTotal(valor) {
  if (valor >= 100) {
    return valor * 0.9;
  }

  return valor;
}
Para a entrada 100, o algoritmo devolve 90. O resultado esperado é 100, pois “acima de 100” não inclui o próprio limite.
Agora a falha pode ser descrita sem ambiguidade:
entrada: 100
esperado: 100
observado: 90
diferença: desconto aplicado no limite excluído pela regra
Essa descrição é muito mais útil do que “o desconto está estranho”. Ela transforma uma percepção em um caso reproduzível.
Sintoma, primeira divergência e causa são pontos diferentes
O sintoma é o que você percebe: total 90 em vez de 100. A causa é a decisão valor >= 100, que aceita uma entrada que deveria seguir pelo outro caminho.
Entre os dois existe a primeira divergência: o primeiro instante em que o estado observado deixa de corresponder ao estado esperado.
No exemplo:
valor recebido          esperado 100 | observado 100
teste da condição       esperado falso | observado verdadeiro  <- primeira divergência
caminho selecionado     esperado sem desconto | observado com desconto
resultado               esperado 100 | observado 90             <- sintoma
Corrigir apenas onde o sintoma aparece pode mascarar a causa. Arredondar 90, somar 10 no retorno ou criar uma exceção exclusiva para 100 atua no fim do percurso. A pergunta diagnóstica é: em qual primeira etapa o algoritmo tomou uma decisão diferente da esperada?
O erro pode nascer em três camadas
Antes de editar código, descubra em qual camada a hipótese está localizada.
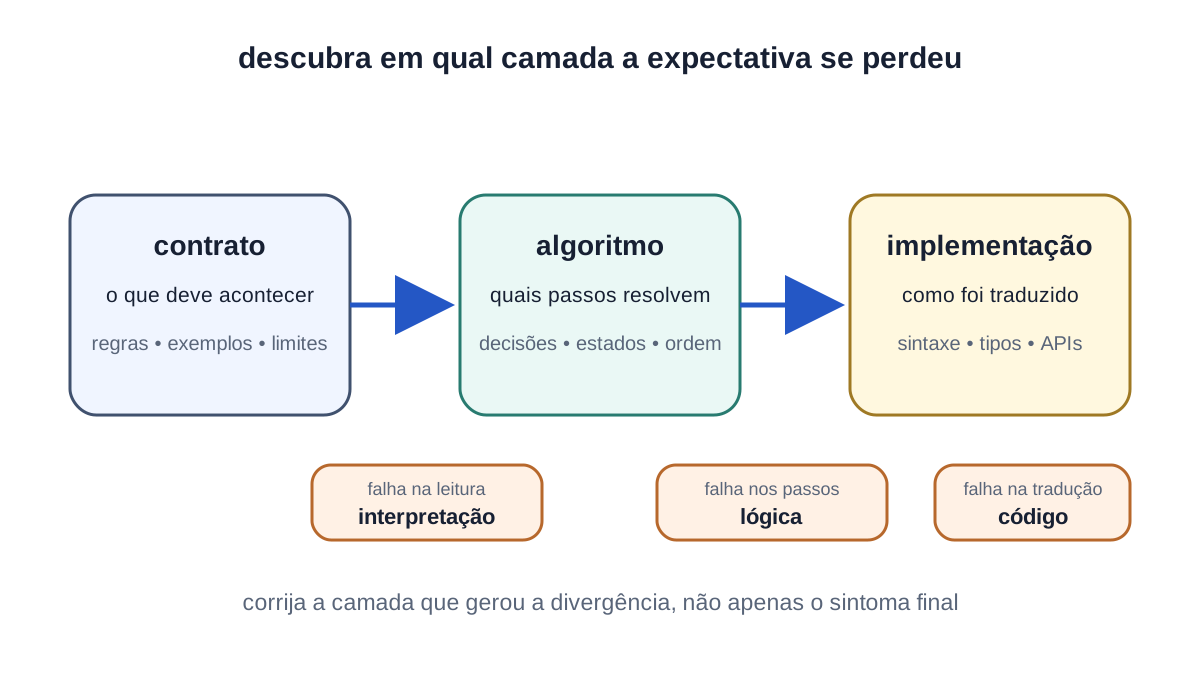
Erro de interpretação
O contrato foi entendido incorretamente. Se a regra original dissesse “a partir de R$ 100”, usar >= 100 estaria correto; alterar para > 100 criaria um erro para satisfazer uma expectativa equivocada.
Confirme exemplos, fronteiras, exceções e significado das palavras antes de investigar o fluxo interno.
Erro de lógica
O problema foi entendido, mas os passos não representam a regra. No caso, “acima de 100” foi traduzido como >= 100 em vez de > 100. O programa pode executar sem qualquer mensagem de erro e ainda produzir uma resposta incorreta.
Erro de implementação
A estratégia pode estar correta no papel, mas foi traduzida incorretamente para a linguagem: parêntese ausente, nome inexistente, tipo incompatível, índice fora do limite ou divisão por zero. Alguns impedem o programa de iniciar; outros surgem durante a execução.
Erros de sintaxe e exceções fornecem pistas, mas a linha indicada nem sempre contém a causa original. Um valor inválido pode ter sido produzido várias chamadas antes.
Congele um caso que reproduza a falha
Antes de procurar a causa, consiga repetir o comportamento nas mesmas condições. Registre:
- entrada exata;
- resultado esperado;
- resultado observado;
- versão do algoritmo;
- configurações relevantes;
- sequência mínima de ações;
- frequência: sempre ou apenas às vezes.
Reduza o exemplo sem remover o erro. Se a falha apareceu em um pedido com vinte itens, verifique se um único valor 100 já a demonstra. Um caso menor reduz o estado que precisa ser acompanhado.
O caso também precisa ser estável. Se cada execução usa horário, sorteio, arquivo ou resposta externa diferente, controle essa dependência para que dois experimentos sejam comparáveis.
Não comece a alterar o algoritmo enquanto ainda não consegue reproduzir o problema. Uma mudança seguida por um resultado diferente pode ser coincidência, não evidência de correção.
Compare esperado e observado em cada fronteira
Execute o algoritmo em etapas e registre somente o estado relevante:
| Etapa | Esperado | Observado | Ainda coincide? |
|---|---|---|---|
entrada valor | 100 | 100 | sim |
valor > 100 | falso | — | — |
| condição implementada | falso | 100 >= 100 → verdadeiro | não |
| total devolvido | 100 | 90 | não |
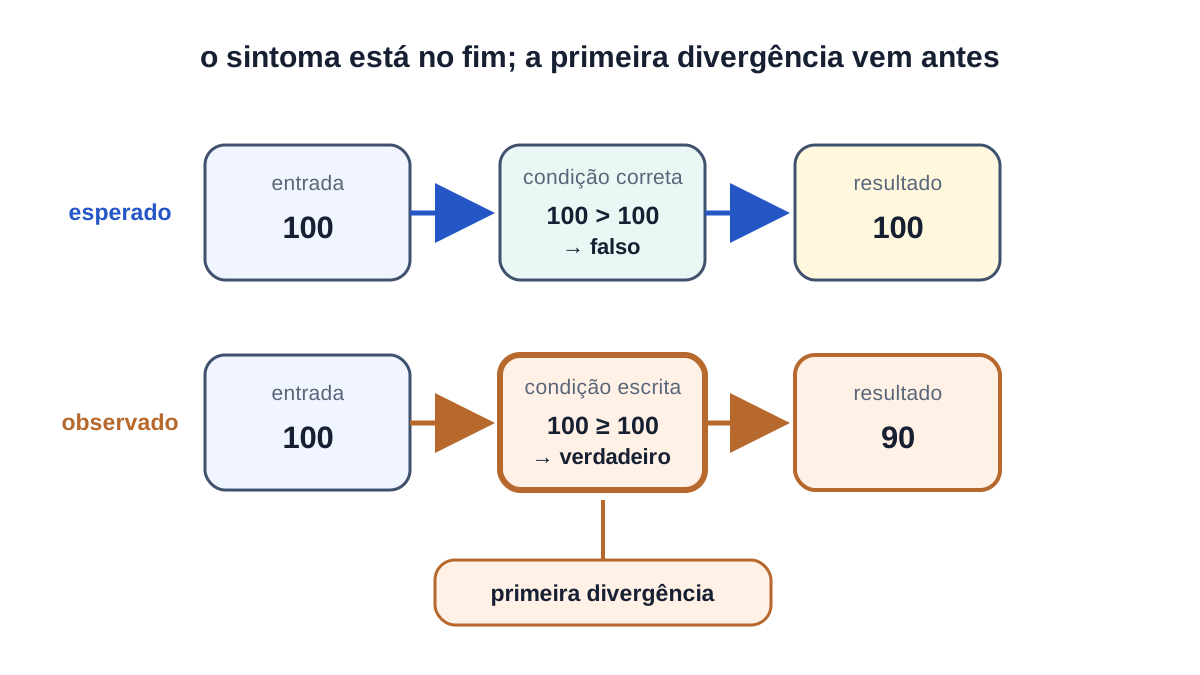
Esse rastro é uma versão concentrada do teste manual de um algoritmo. Não registre todas as variáveis por hábito. Escolha aquelas que podem confirmar ou refutar a hipótese atual.
Formule uma hipótese que possa falhar
Uma hipótese diagnóstica precisa prever uma observação.
Hipótese útil:
O desconto é aplicado em
100porque a condição usa>=; se ela for avaliada, o resultado será verdadeiro exatamente no limite.
Experimento:
const valor = 100;
console.log({ valor, condicao: valor >= 100 });
Resultado previsto: { valor: 100, condicao: true }.
Hipóteses vagas como “deve ser o if”, “o JavaScript calculou errado” ou “tem algo no desconto” não definem o que observar. Torne a explicação específica o suficiente para ser contrariada pelos dados.
Teste uma hipótese por vez. Alterar operador, fórmula, arredondamento e retorno simultaneamente impede saber qual mudança teve efeito e aumenta o risco de criar outra falha.
Divida o percurso para reduzir a área de busca
Quando o algoritmo é longo, coloque um ponto de observação aproximadamente no meio do caminho relevante:
- se o estado já está incorreto, investigue a metade anterior;
- se ainda está correto, investigue a metade posterior;
- repita até localizar a primeira divergência.
Esse raciocínio não exige uma ferramenta específica. Você pode usar uma impressão temporária, uma tabela manual, um teste automatizado ou um breakpoint.
Em uma função com entrada, validação, cálculo e formatação, observe primeiro o valor depois do cálculo. Se estiver correto, a falha provavelmente está na formatação ou saída. Se estiver incorreto, volte para validação e regras anteriores.
Evite “imprimir tudo”. Excesso de saída esconde transições importantes. Registre nome da etapa, entrada relevante e resultado daquela etapa.
Leia mensagens de erro como evidência, não como diagnóstico completo
Uma mensagem de erro costuma informar:
- tipo da falha;
- descrição;
- arquivo e linha onde foi detectada;
- sequência de chamadas que levou ao ponto, quando existe traceback ou pilha.
Em Python:
valores = [10, 20, 30]
print(valores[3])
O programa informa IndexError e mostra a linha do acesso. Isso confirma que o índice usado não pertence à lista, mas ainda resta perguntar por que o algoritmo produziu 3: limite com <=, tamanho confundido com último índice ou incremento duplicado?
Erros de sintaxe podem ser detectados depois do token que realmente faltou. Exceções podem surgir longe da etapa que criou o valor inválido. Leia a mensagem de baixo para cima quando a linguagem apresenta primeiro o tipo e o detalhe final; depois acompanhe as chamadas até encontrar o primeiro ponto pertencente ao seu código.
Não capture uma exceção genérica apenas para esconder a falha. Transformar todo erro em valor padrão elimina evidências e permite que um estado inválido continue circulando.
Use o depurador para pausar e observar estado
Um breakpoint pausa a execução antes de uma instrução. Nesse momento, você pode inspecionar variáveis, avaliar expressões, avançar linha a linha e examinar a pilha de chamadas.
No caso do desconto, pause na condição e confira:
valor = 100
valor >= 100 = verdadeiro
Atenção ao momento: se a execução está parada antes de uma linha, a atribuição daquela linha ainda não aconteceu. Confundir estado anterior com posterior cria uma conclusão falsa.
Recursos mais comuns:
- step over: executa a linha atual sem entrar nos detalhes de uma função chamada;
- step into: entra na função para acompanhar sua execução;
- step out: termina a função atual e retorna ao chamador;
- watch: acompanha uma variável ou expressão escolhida;
- call stack: mostra a sequência de funções que levou ao ponto atual.
Ferramentas aceleram observação; não substituem a definição de esperado, a hipótese nem o experimento.
Aplique a menor correção coerente com a causa
Depois que a evidência confirma o operador incorreto, a mudança é pequena:
function calcularTotal(valor) {
  if (valor > 100) {
    return valor * 0.9;
  }

  return valor;
}
“Menor” não significa um remendo especial como if (valor === 100). Significa alterar somente a regra responsável, preservando o restante do comportamento conhecido.
Registre o motivo da alteração: “a regra exclui o limite; trocar >= por >”. Uma descrição causal é mais útil do que “corrige desconto”.
Se a causa for interpretação, a correção pode estar na especificação, nos exemplos ou no alinhamento com quem definiu a regra — não necessariamente no código.
Confirme a correção e procure regressões próximas
Reexecutar apenas 100 confirma o caso original, mas não prova que o intervalo inteiro continua correto. Teste os vizinhos:
| Entrada | Resultado esperado |
|---|---|
| 99,99 | 99,99 |
| 100 | 100 |
| 100,01 | 90,009 |
| 150 | 135 |
Inclua também entradas inválidas conforme o contrato, como valor negativo, texto ou ausência. Decida se devem ser rejeitadas antes do cálculo.
Um bom fechamento do diagnóstico responde:
- o caso original agora passa?
- os casos que já funcionavam continuam passando?
- os limites vizinhos foram verificados?
- a causa foi removida ou apenas o sintoma foi escondido?
- existe um teste que impediria o mesmo erro de voltar?
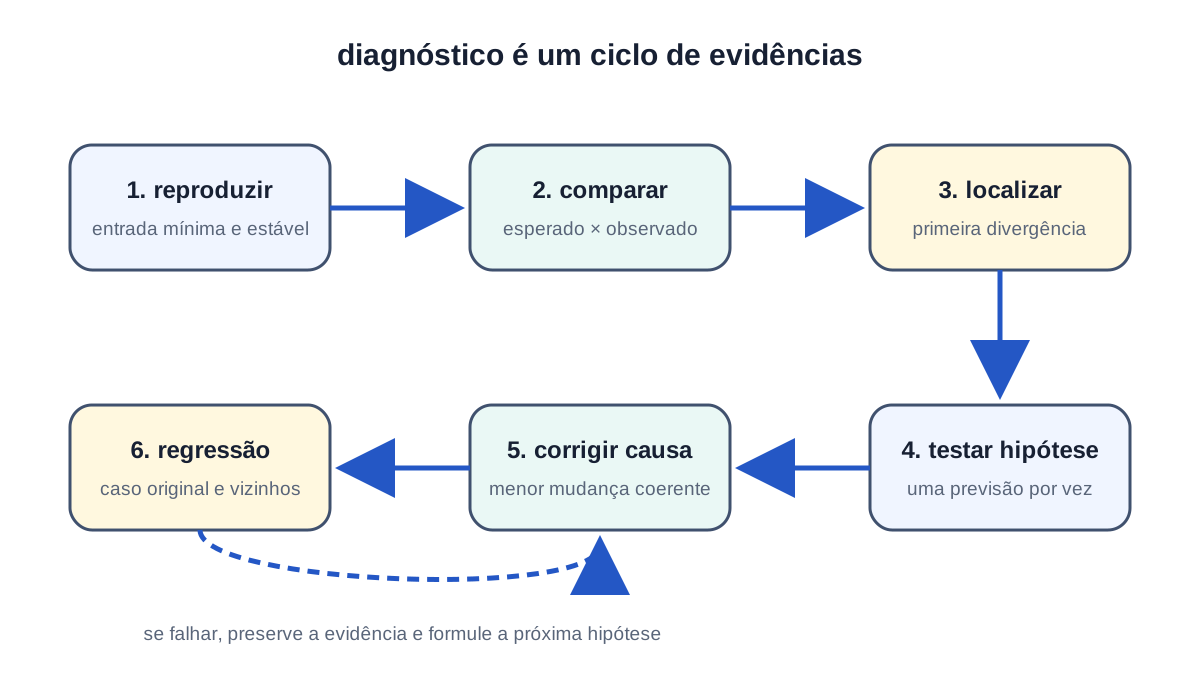
Evite hábitos que destroem evidências
Durante a investigação, evite:
- mudar várias partes antes de executar novamente;
- testar apenas com a entrada que funciona;
- culpar a ferramenta ou a linguagem antes de observar o estado;
- confundir a linha que detectou a falha com a linha que a causou;
- apagar o caso reproduzível depois da correção;
- aceitar “agora funcionou” sem explicar por quê;
- adicionar valores padrão que escondem dados inválidos;
- depurar o sistema inteiro quando uma função pequena reproduz o erro.
Quando uma pausa ajudar, afaste-se e reescreva a regra com um exemplo. Explicar o algoritmo passo a passo também expõe saltos de raciocínio que a leitura rápida normaliza.
Pratique com uma taxa de entrega
A regra informa: compras de até R$ 80 pagam R$ 12 de entrega; acima de R$ 80, a entrega é gratuita.
O algoritmo atual torna a entrega gratuita em 80.
- escreva entrada, esperado e observado;
- classifique hipóteses de interpretação, lógica e implementação;
- crie o menor caso reproduzível;
- rastreie o estado até a primeira divergência;
- formule uma hipótese que preveja o valor da condição;
- corrija apenas a causa confirmada;
- teste
79,99,80,80,01e150; - registre um teste de regressão para o limite;
- explique por que alterar o valor da entrega não corrigiria a causa.
O exercício está completo quando outra pessoa consegue reproduzir a falha e compreender a correção apenas pelo registro.
O que você deve guardar
Depurar não é adivinhar até o resultado mudar. É comparar comportamento esperado e observado, reduzir a falha a um caso reproduzível, localizar a primeira divergência e testar hipóteses com experimentos controlados.
Separe erros de interpretação, lógica e implementação, pois cada camada exige uma correção diferente. Use mensagens, impressões e depuradores como instrumentos de observação. Depois da menor mudança coerente com a causa, reexecute o caso original, as fronteiras e os comportamentos que já funcionavam.
Para registrar laços, decisões e chamadas com maior precisão, avance para teste de mesa e rastreamento de variáveis.
Referências
- MIT OpenCourseWare — Testing, debugging, exceptions and assertions. Acesso em 22 set. 2026.
- Python 3 Documentation — Errors and exceptions. Acesso em 22 set. 2026.
- Microsoft Learn — Tutorial: Debug C# code and inspect data. Acesso em 22 set. 2026.
- Microsoft Learn — Get started with breakpoints. Acesso em 22 set. 2026.
- CS50 — Bugs and debugging. Acesso em 22 set. 2026.