
Redes Neurais Artificiais: Guia Prático em 2026
Entenda redes neurais artificiais: neurônios, camadas, treinamento, backpropagation, overfitting, aplicações, limites e um exemplo prático com Keras.
Redes neurais artificiais são modelos de aprendizado de máquina formados por unidades matemáticas conectadas em camadas.
Elas ajustam pesos a partir de exemplos para reconhecer padrões, classificar informações, estimar valores ou gerar representações úteis de dados complexos.
O nome vem de uma inspiração distante no sistema nervoso, mas uma rede neural não é uma cópia do cérebro, não possui consciência e não “pensa” como uma pessoa.
Na prática, ela executa operações numéricas, mede erros e modifica parâmetros para melhorar uma tarefa bem definida.
Neste guia, você entenderá neurônios, camadas, funções de ativação, propagação direta, retropropagação, treinamento, overfitting e inferência.
Também verá um exemplo com Keras, critérios para decidir quando usar uma rede neural e os cuidados necessários para transformar um bom experimento em um sistema confiável.
O que são redes neurais artificiais?
Uma rede neural artificial é uma função parametrizada: recebe números, executa transformações sucessivas e entrega uma saída.
Os parâmetros — principalmente pesos e vieses — não são programados um a um. Eles são ajustados durante o treinamento para reduzir o erro observado nos exemplos.
Em uma classificação de imagens, as entradas podem ser valores dos pixels e a saída pode representar probabilidades para cada classe.
Em uma previsão de demanda, as entradas podem reunir histórico, preço e calendário, enquanto a saída é um valor contínuo.
Texto e áudio também precisam ser convertidos em representações numéricas antes do processamento.
Redes neurais pertencem ao conjunto de técnicas de machine learning. Elas são uma ferramenta dentro da inteligência artificial, não um sinônimo de toda a área.
O guia sobre o que é inteligência artificial apresenta esse panorama mais amplo.
Como funciona um neurônio artificial
O neurônio artificial recebe entradas, multiplica cada uma por um peso, soma os resultados, acrescenta um viés e aplica uma função de ativação.
Em notação compacta, sua saída pode ser descrita como ativação(soma ponderada + viés). Essa operação simples se torna poderosa quando muitos neurônios são combinados.
- Entrada: uma característica, como idade, temperatura, intensidade de um pixel ou posição em um vetor.
- Peso: indica quanto aquela entrada influencia o neurônio e com qual direção.
- Viés: desloca o ponto em que o neurônio passa a responder.
- Ativação: transforma a soma e introduz o comportamento não linear necessário para aprender relações complexas.
Chamar essa unidade de neurônio é uma analogia histórica útil, mas limitada. Um neurônio biológico é muito mais complexo.
A unidade artificial é uma construção matemática otimizada por software; não reproduz química, consciência, memória humana ou compreensão do mundo.
Camadas de entrada, ocultas e de saída
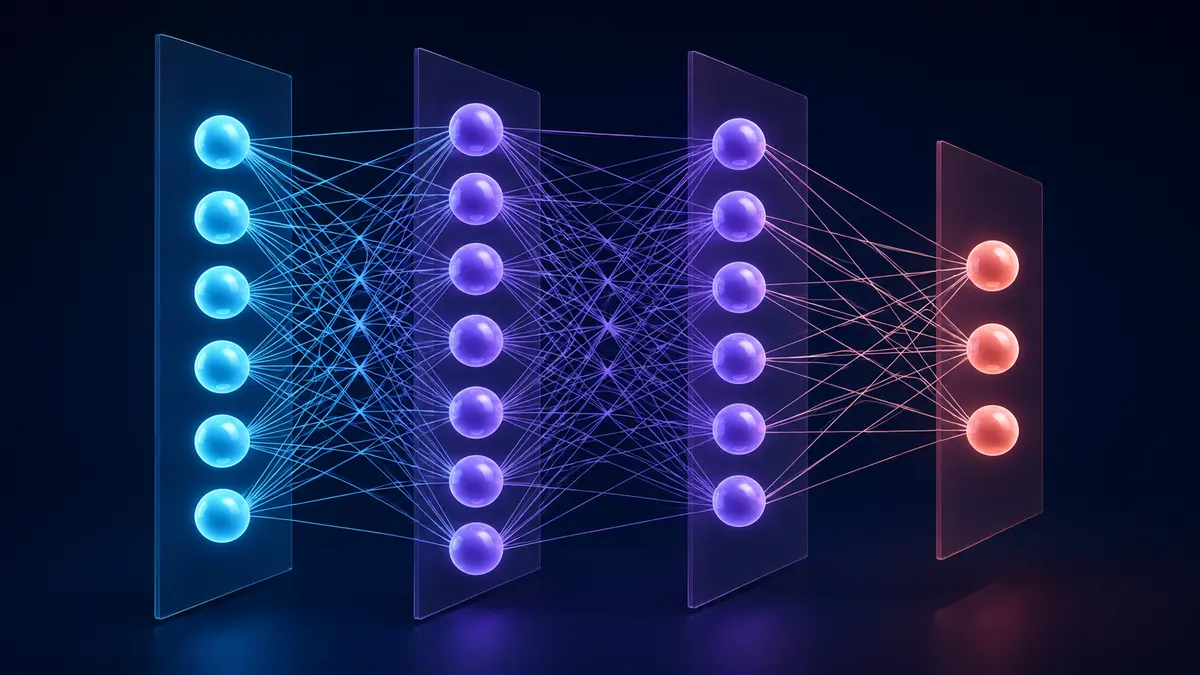
A camada de entrada organiza os atributos que chegam ao modelo. As camadas ocultas transformam essas informações em representações intermediárias.
A camada de saída adapta o resultado ao problema: um valor para regressão, uma probabilidade para classificação binária ou várias pontuações para múltiplas classes.
Em uma camada densa, cada unidade costuma se conectar a todas as unidades da camada anterior.
O número de camadas e neurônios define parte da capacidade do modelo, mas “maior” não significa automaticamente “melhor”.
Uma arquitetura excessiva pode gastar recursos, memorizar ruído e dificultar depuração sem melhorar a generalização.
Propagação direta: da entrada à previsão
Na propagação direta, ou forward pass, os dados percorrem a rede da entrada para a saída. Cada camada usa o resultado da anterior.
Com pesos já definidos, esse fluxo produz uma previsão. Durante o treinamento, a previsão é comparada ao valor esperado; durante a inferência, ela é o resultado usado pela aplicação.
Imagine uma rede que classifica uma transação como legítima ou suspeita. Valores normalizados entram no modelo, as camadas combinam sinais e a saída fornece uma pontuação.
A aplicação ainda precisa transformar essa pontuação em decisão usando um limiar, regras de negócio e, em casos críticos, revisão humana.
Uma previsão não é uma certeza. Ela reflete padrões aprendidos, distribuição dos dados e escolhas de projeto.
O artigo sobre como a inteligência artificial funciona na prática aprofunda a diferença entre aprender no treinamento e aplicar o modelo na inferência.
Funções de ativação e não linearidade
Sem ativações não lineares entre as camadas, empilhar várias transformações lineares continuaria equivalente a uma única transformação linear.
A ativação permite representar fronteiras curvas, interações entre atributos e padrões hierárquicos.
| Função | Uso comum | Cuidado principal |
|---|---|---|
| ReLU | Camadas ocultas em muitos modelos | Unidades podem ficar inativas quando recebem apenas valores negativos |
| Sigmoid | Saída de classificação binária | Pode saturar e reduzir gradientes em camadas profundas |
| Softmax | Saída com classes mutuamente exclusivas | As probabilidades dependem da calibração e não substituem validação |
| Linear | Saída de regressão sem limite fixo | Pode gerar valores fora de faixas aceitáveis para o domínio |
A escolha depende da camada, da tarefa e da função de perda. Não existe uma ativação universal.
O diagnóstico deve observar estabilidade do treinamento, gradientes, métricas de validação e restrições do problema, não apenas copiar uma arquitetura pronta.
Como uma rede neural aprende
Treinar significa procurar valores de parâmetros que diminuam uma medida de erro. O processo repete quatro passos: executa a propagação direta, calcula a perda, obtém gradientes e atualiza os pesos.
Bibliotecas modernas automatizam a diferenciação, mas entender o ciclo ajuda a interpretar falhas.
Função de perda e otimizador
A função de perda traduz o erro em um número que o treinamento tenta minimizar. Entropia cruzada é comum em classificação; erro quadrático médio aparece em regressão.
A escolha errada pode ensinar um objetivo diferente do que o produto realmente precisa.
O otimizador decide como transformar gradientes em atualizações. Gradiente descendente estocástico, Adam e suas variações têm comportamentos diferentes.
A escolha inicial pode seguir uma referência conhecida, mas deve ser validada com curvas de treino, repetição de experimentos e comparação justa.
Retropropagação e gradiente descendente
A retropropagação calcula como cada parâmetro contribuiu para a perda, aplicando a regra da cadeia da saída em direção às primeiras camadas.
O gradiente indica a direção de aumento da perda; o otimizador move os parâmetros, em geral, no sentido oposto.
A documentação do Google sobre backpropagation também alerta para gradientes que desaparecem ou explodem e para unidades ReLU inativas. ReLU, normalização, taxa de aprendizado adequada e arquitetura bem escolhida ajudam, mas a solução depende do sintoma observado.
Época, lote e taxa de aprendizado
- Época: uma passagem completa pelos exemplos do conjunto de treinamento.
- Lote ou batch: subconjunto processado antes de uma atualização dos pesos.
- Taxa de aprendizado: controla o tamanho das atualizações propostas pelo otimizador.
- Iteração: uma atualização feita a partir de um lote.
Taxa alta pode fazer a otimização oscilar ou divergir; taxa muito baixa pode tornar o treinamento lento ou estagnado.
Lotes maiores usam mais memória e produzem gradientes mais estáveis, enquanto lotes menores introduzem ruído que às vezes favorece a busca. O valor adequado é experimental.
Mais épocas também não garantem melhoria. A perda de treino pode continuar caindo enquanto a validação piora. Por isso, checkpoints e parada antecipada devem monitorar uma métrica de validação coerente com o objetivo.
Dados de treino, validação e teste
O conjunto de treino ajusta os parâmetros. O de validação orienta decisões como arquitetura, hiperparâmetros e momento de parar.
O conjunto de teste deve permanecer separado até a avaliação final, oferecendo uma estimativa menos contaminada do comportamento em dados não usados nas escolhas.
Separar linhas aleatoriamente nem sempre é correto. Séries temporais precisam respeitar o tempo; registros do mesmo cliente ou paciente podem exigir agrupamento; imagens quase duplicadas não devem cair em partições diferentes.
Caso contrário, surge vazamento de dados e a métrica fica otimista.
Limpeza, imputação, codificação e normalização devem ser aprendidas apenas com o treino e aplicadas às outras partições.
Classes raras, rótulos inconsistentes e diferenças entre a amostra e o ambiente real precisam ser documentados. Frequentemente, melhorar dados gera mais valor que aumentar a rede.
Overfitting, underfitting e generalização
Underfitting ocorre quando o modelo não aprende nem os padrões relevantes do treino. Overfitting acontece quando ele se ajusta demais aos exemplos conhecidos e falha em novos casos.
Generalização é a capacidade que interessa: manter desempenho útil fora da amostra.
O sinal clássico de overfitting é a perda de treino cair enquanto a perda de validação começa a subir.
A explicação oficial do Google sobre overfitting reforça que desempenho no treino, isoladamente, não demonstra valor no mundo real.
- Coletar exemplos mais representativos e corrigir rótulos.
- Reduzir a capacidade do modelo quando ela excede o problema.
- Aplicar regularização L2, dropout ou aumento de dados quando apropriado.
- Usar parada antecipada com monitoramento da validação.
- Repetir o experimento com sementes e partições adequadas.
Regularização não corrige dados enviesados nem uma divisão incorreta. Ela controla a flexibilidade do modelo; qualidade e representatividade continuam sendo responsabilidades separadas.
Principais arquiteturas de redes neurais
| Arquitetura | Ideia central | Exemplos de uso |
|---|---|---|
| MLP ou rede densa | Camadas totalmente conectadas | Dados tabulares, classificação e regressão |
| CNN | Filtros compartilham pesos e exploram estrutura espacial | Imagens, vídeo e sinais em grade |
| RNN, LSTM e GRU | Estado recorrente representa sequência anterior | Séries temporais, áudio e sequências |
| Transformer | Atenção relaciona elementos de uma sequência | Linguagem, visão, áudio e modelos multimodais |
| Autoencoder | Codifica e reconstrói uma entrada | Representações, compressão e detecção de anomalias |
A tabela é um mapa, não uma regra absoluta. Transformers dominam muitos problemas sequenciais, mas modelos recorrentes ainda podem ser úteis sob restrições específicas.
CNNs continuam eficientes em várias tarefas visuais. Em dados tabulares pequenos, métodos de árvores frequentemente merecem comparação antes de uma rede densa.
Aplicações práticas
- Visão computacional: classificação, detecção, segmentação e inspeção de imagens.
- Linguagem: tradução, busca semântica, resumo e geração de texto.
- Áudio: reconhecimento de fala, identificação de eventos e síntese.
- Recomendação: representação de usuários e itens para ordenar alternativas.
- Previsão: demanda, risco, manutenção e comportamento, quando os dados sustentam a tarefa.
- Detecção de anomalias: identificação de padrões incomuns em transações, sensores ou operações.
Para aprofundar duas áreas, consulte os guias de visão computacional e linguagem natural na inteligência artificial.
Em medicina, crédito, segurança e mobilidade, o modelo deve apoiar um sistema de governança proporcional ao risco; uma pontuação isolada não substitui validação clínica, jurídica ou operacional.
Exemplo prático com Keras
O exemplo abaixo cria uma rede densa para classificação binária. Ele supõe que x_train e x_test já foram normalizados, que cada amostra possui 20 atributos e que os rótulos são 0 ou 1.
Em um projeto real, a preparação e a divisão dos dados precisam fazer parte de um pipeline reproduzível.
import keras
from keras import layers

model = keras.Sequential([
    keras.Input(shape=(20,)),
    layers.Dense(64, activation="relu"),
    layers.Dropout(0.2),
    layers.Dense(32, activation="relu"),
    layers.Dense(1, activation="sigmoid")
])

model.compile(
    optimizer="adam",
    loss="binary_crossentropy",
    metrics=["accuracy"]
)

early_stop = keras.callbacks.EarlyStopping(
    monitor="val_loss",
    patience=5,
    restore_best_weights=True
)

history = model.fit(
    x_train,
    y_train,
    validation_split=0.2,
    epochs=100,
    batch_size=32,
    callbacks=[early_stop],
    verbose=0
)

loss, accuracy = model.evaluate(x_test, y_test, verbose=0)
probabilities = model.predict(x_test, verbose=0)
O modelo Sequential é apropriado para uma pilha simples em que cada camada possui uma entrada e uma saída.
A documentação oficial do Keras recomenda outras APIs para topologias com múltiplas entradas, saídas, compartilhamento de camadas ou conexões não lineares.
A chamada fit treina, evaluate mede no conjunto de teste e predict produz probabilidades.
O limiar de classificação não precisa ser 0,5: ele deve refletir custo de falsos positivos, falsos negativos e capacidade operacional.
A acurácia exibida serve apenas como ponto de partida.
Como avaliar o modelo além da acurácia
Acurácia pode esconder falhas quando as classes são desbalanceadas. Em um conjunto com 99% de casos negativos, prever sempre “negativo” gera 99% de acurácia e nenhuma utilidade para encontrar o evento raro.
- Precisão: entre os positivos previstos, quantos estavam corretos.
- Recall ou sensibilidade: entre os positivos reais, quantos foram encontrados.
- F1: combina precisão e recall em uma média harmônica.
- ROC-AUC e PR-AUC: avaliam ordenação em vários limiares; PR-AUC costuma ser informativa em eventos raros.
- Calibração: verifica se probabilidades previstas correspondem a frequências observadas.
- Métricas por grupo: revelam diferenças que uma média global esconde.
A métrica precisa conversar com a consequência do erro. Em triagem, deixar passar um caso pode custar mais que gerar uma revisão extra.
Em bloqueio automático, o falso positivo pode prejudicar pessoas legítimas. Matriz de confusão, curvas, intervalos de confiança e análise manual de erros tornam o diagnóstico mais concreto.
Inferência, implantação e monitoramento
Um notebook com boa métrica não é ainda um produto. A implantação precisa empacotar o mesmo pré-processamento, versionar modelo e dados, definir contratos de entrada e saída, controlar latência, lidar com falhas e registrar informações suficientes para auditoria sem expor dados sensíveis.
Na inferência, o modelo aplica pesos congelados. Ela costuma ser mais barata que o treinamento, mas o custo varia com arquitetura, volume, tamanho de lote, hardware e exigência de resposta.
Compressão, quantização, poda e modelos menores podem reduzir recursos, desde que a qualidade seja reavaliada.
Depois da publicação, monitore distribuição das entradas, taxa de erros, latência, uso de recursos, qualidade por segmento e sinais de drift. Quando rótulos reais chegam com atraso, use indicadores operacionais e amostragens revisadas.
Retreinamento deve ser acionado por critérios e validação, não por calendário cego.
Limitações, vieses e segurança
Redes neurais aprendem correlações presentes nos dados. Se a amostra reproduz desigualdades, omite grupos ou contém rótulos enviesados, o modelo pode amplificar o problema.
Remover um atributo sensível não elimina automaticamente variáveis que funcionam como substitutas.
- Interpretabilidade: modelos grandes podem dificultar a explicação de uma previsão específica.
- Robustez: pequenas mudanças, ruído ou entradas fora da distribuição podem alterar resultados.
- Privacidade: dados de treino, logs e previsões podem conter informações pessoais ou confidenciais.
- Segurança: entradas adversariais, envenenamento de dados e extração do modelo exigem controles.
- Custo: treino e inferência consomem computação, energia, tempo de engenharia e orçamento.
Controles úteis incluem minimização de dados, avaliação por subgrupos, revisão humana, testes de abuso, acesso restrito, documentação de limitações e plano de resposta a incidentes.
Quanto maior o impacto sobre direitos, dinheiro, saúde ou segurança, maior deve ser a exigência de evidência e supervisão.
Quando usar uma rede neural
Redes neurais se destacam quando há dados suficientes, relações complexas e uma tarefa na qual representações aprendidas agregam valor — especialmente imagens, áudio, texto e problemas em grande escala.
Transfer learning pode aproveitar um modelo pré-treinado e reduzir a necessidade de começar do zero.
Modelos mais simples devem entrar na comparação quando os dados são tabulares e limitados, a explicabilidade é central, a latência é extremamente restrita ou uma regra de negócio resolve o caso.
Regressão, árvores e métodos de gradient boosting frequentemente oferecem uma linha de base forte, mais barata e fácil de explicar.
- Defina a decisão e a métrica de negócio antes da arquitetura.
- Construa uma linha de base simples e mensurável.
- Verifique volume, qualidade, representatividade e autorização de uso dos dados.
- Estime custo de treino, inferência, monitoramento e retreinamento.
- Escolha a rede somente se o ganho justificar complexidade e risco adicionais.
Roteiro de estudos e prática
Comece por vetores, matrizes, funções, probabilidade básica e avaliação de modelos.
Depois, implemente regressão e classificação simples, entenda divisão de dados e só então avance para perceptrons multicamadas.
Visualizar curvas de perda e investigar exemplos errados ensina mais que apenas executar um notebook.
- Treine uma rede pequena em dados sintéticos e altere uma variável por vez.
- Compare ativações, tamanhos de camada e taxas de aprendizado.
- Provoque overfitting e teste dropout ou parada antecipada.
- Meça precisão, recall, matriz de confusão e calibração.
- Salve o modelo, carregue-o e execute inferência em dados novos.
- Reproduza o experimento com outra semente e registre os resultados.
Python reúne bibliotecas e material didático abundante; o comparativo Java ou Python ajuda a entender a escolha de linguagem.
Keras oferece uma entrada de alto nível, enquanto o tutorial oficial do PyTorch para construir redes mostra como camadas são organizadas em módulos.
Perguntas frequentes
Rede neural e deep learning são a mesma coisa?
Deep learning usa redes neurais com múltiplas camadas e grande capacidade para aprender representações. Toda solução de deep learning emprega redes neurais, mas uma rede pequena e rasa nem sempre é chamada de aprendizado profundo.
Redes neurais sempre precisam de muitos dados?
Não existe um número universal. A necessidade depende da dificuldade da tarefa, variedade dos casos, ruído, tamanho do modelo e uso de pré-treinamento. Transfer learning, aumento de dados e modelos menores ajudam, mas não compensam exemplos incorretos ou uma amostra que não representa o ambiente real.
É preciso saber cálculo para começar?
É possível executar os primeiros experimentos sem dominar cálculo, porque as bibliotecas calculam gradientes. Para compreender backpropagation, diagnosticar instabilidade e projetar soluções com autonomia, derivadas, álgebra linear e probabilidade tornam-se importantes.
Qual linguagem é mais usada?
Python é a escolha mais comum para aprendizado e experimentação graças ao ecossistema de dados e frameworks. Produção pode incluir Python, C++, Java, JavaScript ou runtimes especializados, conforme latência, plataforma e infraestrutura.
Uma rede neural explica suas decisões?
Não de forma completa e automática. Existem técnicas para medir importância, visualizar ativações ou aproximar a contribuição de atributos, mas elas têm limites. Em decisões de alto impacto, a explicação precisa ser testada, contextualizada e combinada com documentação, revisão e alternativas de contestação.
Conclusão
Redes neurais artificiais transformam entradas em previsões por meio de camadas, pesos, vieses e ativações.
No treinamento, função de perda, retropropagação e otimização ajustam os parâmetros; na inferência, o modelo aplica o que aprendeu a novos dados.
O resultado depende menos da aparência sofisticada da arquitetura e mais da clareza do problema, qualidade dos dados, separação correta das amostras, métrica adequada e validação fora do treino.
Em produção, monitoramento, segurança, privacidade e governança fazem parte do sistema tanto quanto o modelo.
Para praticar, construa uma rede pequena, compare-a com uma linha de base simples e investigue cada erro.
Esse processo cria uma compreensão mais sólida do que apenas aumentar camadas ou repetir exemplos prontos.