
Machine Learning para Iniciantes: Como Funciona em 2026
Entenda como Machine Learning aprende com dados, conheça os principais tipos, métricas, erros e uma trilha prática para começar.
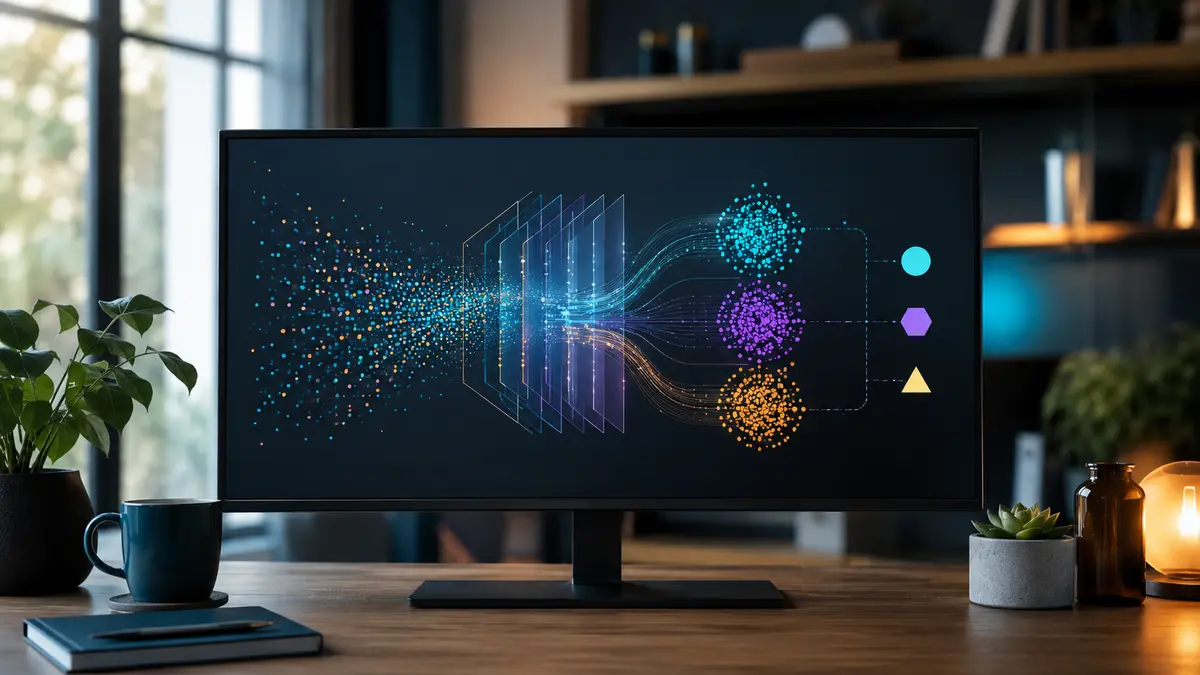
Machine Learning é uma forma de ensinar software a reconhecer padrões nos dados para fazer previsões, classificações ou recomendações sem escrever uma regra específica para cada caso.
Em vez de programar milhares de condições para separar spam, por exemplo, fornecemos mensagens já avaliadas e deixamos o algoritmo encontrar combinações úteis.
Isso não significa que a máquina “pensa” como uma pessoa nem que aprende sozinha para sempre.
Alguém precisa definir o problema, selecionar dados, escolher uma abordagem, medir os erros e monitorar o comportamento depois da publicação.
Um modelo pode atingir boa pontuação em um teste e ainda falhar no mundo real porque os dados mudaram ou porque a métrica não representa a decisão importante.
Este guia apresenta Machine Learning para iniciantes com linguagem direta, exemplos e um fluxo completo: do problema à avaliação.
O objetivo é oferecer base suficiente para entender projetos, iniciar os estudos e reconhecer promessas exageradas, sem competir com tutoriais específicos de programação ou com explicações aprofundadas de redes neurais.
O que é Machine Learning: resposta rápida
A definição prática é simples: Machine Learning, ou aprendizado de máquina, usa dados históricos para ajustar um modelo capaz de estimar algo em novos dados.
Se a saída for uma categoria — fraude ou não fraude — temos classificação. Se for um valor numérico — demanda prevista — temos regressão. Se o objetivo for encontrar grupos sem rótulos, temos agrupamento.
| Componente | Pergunta | Exemplo |
|---|---|---|
| Dados | Quais exemplos estão disponíveis? | Compras anteriores de clientes |
| Atributos | O que descreve cada exemplo? | Valor, horário, categoria e canal |
| Rótulo | Qual resultado queremos prever? | Compra legítima ou suspeita |
| Modelo | Que padrão foi ajustado? | Combinação de sinais de risco |
| Métrica | Como mediremos o erro? | Precisão, recall e custo operacional |
| Inferência | Como usar o modelo? | Avaliar uma compra nova |
Nem todo problema precisa de Machine Learning. Se uma regra clara resolve com baixo custo — bloquear uma data inválida ou aplicar uma fórmula fiscal — uma solução determinística costuma ser mais simples de explicar, testar e manter.
ML faz mais sentido quando o padrão é complexo, há exemplos representativos e o erro pode ser medido.
IA, Machine Learning e Deep Learning: qual é a diferença?
Inteligência Artificial é o campo mais amplo: reúne técnicas para executar tarefas associadas a percepção, linguagem, decisão e geração de conteúdo.
Machine Learning é uma área dentro da IA que ajusta modelos a partir de dados.
Deep Learning é uma família de Machine Learning baseada em redes neurais com várias camadas, especialmente útil em imagem, áudio, linguagem e grandes volumes de dados.
Uma regra de negócio pode ser apresentada como IA em linguagem comercial, mas não necessariamente usa aprendizado de máquina.
Da mesma forma, regressão linear e árvore de decisão são Machine Learning sem serem Deep Learning.
O artigo sobre a diferença entre IA, Machine Learning e Deep Learning aprofunda essa relação; aqui seguimos para o funcionamento de um projeto.
IA generativa também usa Machine Learning, frequentemente Deep Learning, para produzir texto, imagem, áudio ou código.
Porém, a maior parte dos projetos empresariais de ML continua resolvendo previsão, classificação, recomendação, detecção de anomalias e priorização. Chatbots são apenas uma parte do cenário.
Como Machine Learning funciona na prática
Imagine uma planilha com milhares de pedidos. Para cada linha, sabemos valor, horário, região, meio de pagamento e se houve fraude confirmada. Um algoritmo procura relações entre esses atributos e o resultado.
Ao receber um pedido novo, o modelo calcula uma pontuação ou classe com base no padrão aprendido.
A introdução oficial do Google a Machine Learning organiza os sistemas em aprendizado supervisionado, não supervisionado, por reforço e IA generativa.
Essa divisão é útil, mas o princípio permanece: dados representam exemplos; um procedimento ajusta parâmetros; e o modelo produz uma saída para entradas novas.
Dados, atributos e rótulos
Cada linha, imagem ou evento é um exemplo. Os atributos — também chamados de features — são as informações fornecidas ao modelo. O rótulo é a resposta conhecida usada no aprendizado supervisionado.
Em preços de imóveis, metragem, bairro e idade podem ser atributos; o preço de venda, o rótulo.
Quantidade não compensa automaticamente baixa qualidade. Rótulos inconsistentes, dados duplicados, períodos incomparáveis e informações coletadas depois do resultado criam modelos enganosos.
Entender de onde cada coluna veio costuma valer mais que testar dezenas de algoritmos. O guia sobre como algoritmos aprendem com dados explora essa ligação.
Treinamento e inferência
Treinamento é a etapa em que o algoritmo ajusta os parâmetros para reduzir uma função de erro. Inferência é o uso posterior do modelo já treinado para gerar uma previsão.
Um sistema pode treinar uma vez por semana e executar milhares de inferências por minuto; outro pode ser atualizado continuamente.
Essa distinção afeta custo e arquitetura. Treinar uma rede grande pode exigir GPU e muitas horas. Usar um modelo pequeno de árvore pode ser rápido em CPU.
O melhor projeto não é o modelo mais pesado, e sim o que atende qualidade, latência, custo, explicabilidade e manutenção exigidos.
Principais tipos de Machine Learning
Aprendizado supervisionado
No aprendizado supervisionado, os exemplos possuem respostas conhecidas. Classificação prevê categorias, como spam ou não spam; regressão estima valores, como consumo elétrico.
É a abordagem mais direta para medir porque podemos comparar a previsão com o rótulo real em dados separados.
O desafio está nos rótulos. Fraude confirmada pode demorar semanas; cancelamento pode ter definições diferentes; avaliação humana pode discordar.
Antes de modelar, documente quem produz o rótulo, em que momento e com qual margem de erro.
Aprendizado não supervisionado
Aqui não existe resposta pronta para cada exemplo. O algoritmo procura estrutura: grupos semelhantes, componentes que resumem variáveis ou pontos muito diferentes dos demais. Segmentação exploratória de clientes e detecção inicial de anomalias são usos comuns.
Um grupo encontrado não vem com significado de negócio. Pessoas precisam interpretar se o agrupamento é estável, útil e eticamente aceitável.
Encontrar três clusters não prova que existam três tipos naturais de consumidor; pode apenas refletir escala, seleção de atributos ou configuração do algoritmo.
Aprendizado semi-supervisionado
Combina uma pequena parte de exemplos rotulados com muitos exemplos sem rótulo. Pode ajudar quando classificar dados exige especialistas ou custa caro, como revisar imagens técnicas.
A economia só é real quando o método preserva qualidade e inclui auditoria; rótulos automáticos incorretos podem amplificar o erro.
Aprendizado por reforço
Um agente escolhe ações em um ambiente e recebe recompensas ou penalidades. O objetivo é aprender uma política que maximize o retorno ao longo do tempo.
Jogos, robótica, controle e otimização sequencial são exemplos. Diferentemente de uma classificação isolada, uma ação pode afetar os estados e recompensas futuras.
Definir a recompensa é delicado. Se ela mede apenas velocidade, o agente pode sacrificar segurança; se premia cliques, pode favorecer conteúdo apelativo. A métrica escolhida se transforma no comportamento perseguido.
Onde a IA generativa entra nessa história
Modelos generativos aprendem distribuições e padrões para criar novas saídas. Grandes modelos de linguagem preveem unidades de texto em sequência; modelos de imagem aprendem representações visuais.
Eles são treinados com técnicas de Machine Learning, embora a escala e o modo de interação escondam parte do fluxo tradicional.
Para um iniciante, regressão e classificação continuam excelentes para entender atributos, perda, generalização e avaliação.
Esses conceitos reaparecem em sistemas generativos, junto de novos desafios como alucinação, segurança de conteúdo e avaliação aberta.
O fluxo de um projeto de Machine Learning
1. Definir o problema e a decisão
Comece pela decisão que a previsão apoiará. “Usar IA para reduzir cancelamento” é vago. “Priorizar clientes com maior probabilidade de cancelar nos próximos 30 dias para uma equipe com capacidade de 500 contatos” define horizonte, público, ação e restrição. Agora é possível escolher rótulo e medir impacto.
Pergunte também se a previsão chegará a tempo, se existe ação possível e qual o custo de cada erro. Prever algo inevitável não gera valor. Uma automação sem responsável pode transformar probabilidade em decisão definitiva sem revisão.
2. Coletar e preparar os dados
Una as fontes necessárias, verifique permissões, remova duplicatas, trate ausências e investigue distribuições.
Não preencha valores automaticamente sem entender por que faltam. A ausência de informação pode ser um sinal do processo ou um viés de coleta.
Transformações devem ser reproduzíveis. Se o treinamento converte datas, categorias e escalas de um jeito, a inferência precisa repetir exatamente o mesmo processo.
Pipelines evitam que o modelo receba uma estrutura diferente em produção. Para preparar bases com Python, consulte o guia de Pandas e NumPy para manipulação de dados.
3. Separar treino, validação e teste
Treino ajusta o modelo; validação orienta escolhas de algoritmo e hiperparâmetros; teste estima o desempenho final em dados não usados nas decisões.
Se o teste influencia repetidamente os ajustes, deixa de ser uma avaliação independente e vira outra validação.
A divisão precisa respeitar o problema. Em séries temporais, treinar no futuro e testar no passado é irreal. Dados da mesma pessoa, equipamento ou empresa podem precisar ficar no mesmo conjunto para evitar que características quase idênticas apareçam dos dois lados.
Validação cruzada ajuda a usar os dados com eficiência; a documentação do scikit-learn sobre validação cruzada apresenta estratégias e cuidados.
4. Treinar e avaliar o modelo
Comece por um baseline simples, treine um modelo interpretável e registre os experimentos. Compare métricas no conjunto correto, analise erros por grupos e observe estabilidade.
Uma melhora de décimos pode não justificar um modelo dez vezes mais caro ou difícil de explicar.
A avaliação deve simular a operação. Se apenas 1% dos eventos é fraude, acertar sempre “não fraude” entrega 99% de acurácia e zero utilidade. A métrica depende do objetivo e do custo relativo de falso positivo e falso negativo.
5. Publicar, monitorar e revisar
Depois de disponibilizado, o modelo recebe dados novos. Monitore latência, erros técnicos, distribuição das entradas, qualidade das previsões quando os rótulos chegam e impacto da decisão.
Mudança de comportamento, mercado ou produto pode tornar o padrão histórico obsoleto.
Defina responsável, frequência de revisão, critérios de retreinamento e plano de reversão. Um modelo é uma dependência de software e uma hipótese estatística viva, não um arquivo terminado.
O artigo sobre treinamento de modelos de IA detalha esse ciclo.
Algoritmos comuns e quando aparecem
| Algoritmo | Tarefa típica | Vantagem inicial | Atenção |
|---|---|---|---|
| Regressão linear | Prever valor numérico | Simples e interpretável | Relações complexas exigem preparação ou outro modelo |
| Regressão logística | Classificação e probabilidade | Boa linha de base | Depende de atributos informativos |
| Árvore de decisão | Classificação ou regressão | Regras visualizáveis | Uma árvore profunda sofre overfitting |
| Random forest | Dados tabulares | Robusta e pouco sensível a escala | Menos interpretável que uma árvore |
| Gradient boosting | Dados tabulares e ranking | Desempenho forte | Exige ajuste e controle de vazamento |
| K-means | Agrupamento | Rápido e fácil de testar | O número e formato dos grupos são suposições |
| Redes neurais | Imagem, texto, áudio e padrões complexos | Aprendem representações ricas | Dados, computação e avaliação mais exigentes |
Não existe algoritmo universalmente melhor. Dados tabulares pequenos podem favorecer árvores e modelos lineares; imagem e linguagem frequentemente usam redes neurais.
Restrições de memória, tempo de resposta, explicabilidade e licenciamento também fazem parte da escolha.
Exemplo prático: prever cancelamento de clientes
Suponha que um serviço por assinatura queira priorizar contatos de retenção. Cada exemplo representa um cliente em uma data de referência.
Atributos incluem tempo de contrato, falhas recentes, uso, forma de pagamento e chamados anteriores.
O rótulo indica se houve cancelamento nos 30 dias seguintes.
- Defina quem é elegível e qual ação a equipe tomará.
- Crie os exemplos usando apenas informações disponíveis na data de referência.
- Separe períodos anteriores para treino e um período posterior para teste.
- Compare uma regressão logística com uma árvore ou ensemble.
- Meça recall entre os clientes que cabem na capacidade de contato.
- Analise falsos positivos, grupos pouco representados e custo da oferta.
- Execute um piloto com grupo de controle para medir efeito real.
- Monitore mudança de comportamento e retire atributos inadequados.
O modelo não prova que uma ação causará retenção. Ele estima probabilidade com base no histórico. Clientes de alto risco podem ser justamente os menos influenciáveis.
Por isso, previsão deve ser combinada com experimento e conhecimento do processo.
Como saber se um modelo é bom
“Acurácia de 95%” não basta sem prevalência, conjunto de avaliação e comparação. Métricas traduzem diferentes tipos de erro; algumas medem ranking, outras probabilidade ou distância.
Escolha antes de olhar os resultados para reduzir a tentação de destacar apenas o número favorável.
Métricas de classificação
- Acurácia: proporção total de acertos; pode enganar em classes desequilibradas.
- Precisão: entre os casos marcados como positivos, quantos eram realmente positivos.
- Recall ou sensibilidade: entre os positivos reais, quantos foram encontrados.
- F1: média harmônica entre precisão e recall; útil quando ambos importam.
- ROC AUC: capacidade de ordenar positivos acima de negativos em vários limites.
- PR AUC: costuma ser mais informativa quando a classe positiva é rara.
- Calibração: verifica se probabilidades previstas correspondem às frequências observadas.
O limite de decisão altera precisão e recall. Em triagem de segurança, pode ser aceitável revisar mais casos para perder menos ameaças.
Em comunicação com clientes, excesso de falsos alertas pode gerar custo e desgaste. A escolha é operacional, não apenas matemática.
Métricas de regressão
- MAE: média do erro absoluto, fácil de interpretar na unidade do alvo.
- MSE e RMSE: penalizam erros grandes com mais intensidade.
- R²: compara a variância explicada, mas não substitui a análise do erro real.
- Erro percentual: útil em alguns contextos, problemático quando o valor real se aproxima de zero.
Analise também resíduos por faixa, região e tempo. Uma média aceitável pode esconder erro muito maior em produtos caros ou grupos pequenos. Métrica agregada é o começo da investigação, não o final.
Compare com uma linha de base
Classificar pela classe mais comum, repetir o último valor ou usar uma regra existente cria uma referência.
Se o modelo complexo não supera essa linha de base com margem relevante, o projeto ainda não justificou a complexidade. Compare também custo total, tempo de resposta e estabilidade.
Overfitting, vazamento e outros erros comuns
- Overfitting: o modelo memoriza particularidades do treino e não generaliza.
- Underfitting: o modelo ou os atributos são simples demais para capturar o padrão.
- Vazamento de dados: informação indisponível no momento da previsão entra no treinamento.
- Desequilíbrio: a classe rara fica escondida pela métrica agregada.
- Mudança de distribuição: os dados atuais deixam de se parecer com os históricos.
- Rótulo inadequado: a resposta disponível não representa o objetivo real.
- Correlação espúria: o modelo usa um atalho que não se sustenta fora da amostra.
- Otimização da métrica errada: melhora técnica não produz impacto útil.
- Teste contaminado: decisões repetidas são tomadas olhando o conjunto final.
- Ausência de monitoramento: degradação só é descoberta depois de causar dano.
A defesa combina divisão correta, pipeline reproduzível, validação temporal ou por grupos, análise de erro e documentação.
Regularização e modelos menores ajudam no overfitting, mas não corrigem rótulos ruins nem vazamento estrutural.
Aplicações práticas de Machine Learning
- Recomendação: ordenar produtos, músicas ou conteúdos com base no contexto e histórico.
- Detecção de fraude: priorizar transações com sinais incomuns para bloqueio ou análise.
- Previsão de demanda: estimar vendas e apoiar estoque, capacidade e logística.
- Manutenção preditiva: detectar padrões que antecedem falhas em equipamentos.
- Visão computacional: classificar imagens, localizar objetos e inspecionar defeitos.
- Processamento de linguagem: classificar intenção, sentimento ou assunto de mensagens.
- Saúde: apoiar triagem e pesquisa sob validação clínica e supervisão adequada.
- Cibersegurança: detectar anomalias, priorizar alertas e reconhecer comportamentos.
- Finanças: estimar risco, inadimplência ou volatilidade com controles regulatórios.
- Agricultura: analisar imagens, clima e sensores para apoiar manejo.
O mesmo algoritmo pode aparecer em setores diferentes. O que muda é o dado, o custo do erro, a explicação exigida e a governança. Uma recomendação de filme tolera erros que seriam inaceitáveis em crédito, saúde ou segurança.
Ferramentas para começar
Python domina o aprendizado introdutório por reunir NumPy, Pandas, Matplotlib e scikit-learn. Jupyter e Google Colab permitem combinar explicação, código e resultados.
Para redes neurais, TensorFlow/Keras e PyTorch são caminhos comuns. SQL continua essencial para obter e verificar dados em projetos reais.
Se programação ainda é novidade, comece pelo guia de introdução ao Python. Quando estiver confortável com tabelas e funções, avance para o artigo de Machine Learning com Python.
A sequência evita usar bibliotecas como caixas-pretas antes de compreender entradas e resultados.
Os tutoriais oficiais do TensorFlow oferecem notebooks executáveis, inclusive uma classificação básica de imagens.
Eles são úteis depois que você já entende separação de dados, função de perda e avaliação; executar células sem interpretar o resultado não consolida o conceito.
Um primeiro projeto possível
Escolha um conjunto de dados tabular pequeno, com licença clara e objetivo compreensível. Faça análise exploratória, crie um baseline, treine regressão logística ou árvore, avalie em teste separado e escreva uma conclusão com limitações.
Evite começar por chatbot, bolsa de valores ou diagnóstico médico: são projetos mais difíceis de avaliar e carregam riscos adicionais.
Um bom portfólio mostra raciocínio, não apenas pontuação. Explique a origem dos dados, as hipóteses, a divisão, a métrica, os erros encontrados e o que faria antes de colocar o modelo em produção.
Limites, vieses e uso responsável
Modelos reproduzem padrões dos dados e das decisões históricas, inclusive desigualdades. Remover um atributo sensível não garante neutralidade, pois outras variáveis podem funcionar como proxies. Avalie desempenho por grupos relevantes, envolva pessoas afetadas e limite automação em decisões de alto impacto.
Privacidade também começa na coleta. Use apenas dados necessários, defina retenção e acesso, documente consentimento ou outra base adequada e proteja identificadores.
Dados disponíveis tecnicamente não são automaticamente apropriados para treinamento.
O AI Risk Management Framework do NIST organiza a gestão de riscos nas funções Govern, Map, Measure e Manage.
Para um projeto pequeno, isso se traduz em responsáveis claros, contexto documentado, avaliação técnica e humana, monitoramento e capacidade de interromper o sistema.
Explique o papel do modelo às pessoas. Uma pontuação é uma estimativa, não um fato.
Interfaces devem apresentar incerteza, permitir contestação quando necessário e evitar que operadores tratem a saída como ordem incontestável.
Trilha de estudos para iniciantes
- Aprenda Python básico: variáveis, condições, funções, listas e arquivos.
- Revise estatística descritiva, probabilidade básica e interpretação de gráficos.
- Pratique NumPy e Pandas com limpeza e exploração de tabelas.
- Entenda classificação, regressão, treino, validação, teste e baseline.
- Implemente regressão linear, logística e árvore com scikit-learn.
- Aprenda métricas, overfitting, regularização e validação cruzada.
- Construa dois projetos pequenos com documentação e análise de erros.
- Estude pipelines, versionamento, APIs e monitoramento.
- Depois, escolha uma especialização: visão, linguagem, recomendação ou MLOps.
- Só então aprofunde redes neurais e modelos generativos conforme o objetivo.
O Machine Learning Crash Course do Google reúne módulos de regressão, classificação, dados e avaliação com exercícios.
Use o curso em paralelo a um projeto próprio; alternar conceito e prática ajuda a perceber onde a compreensão ainda está frágil.
Checklist antes de confiar em uma previsão
- O problema e a decisão apoiada estão definidos.
- Existe uma linha de base simples para comparação.
- Os dados representam o cenário em que o modelo será usado.
- Atributos usam somente informações disponíveis no momento da previsão.
- Treino, validação e teste foram separados de forma realista.
- A métrica representa o custo dos erros.
- Resultados foram analisados por período e grupos relevantes.
- Probabilidades e limites foram calibrados para a operação.
- Há responsável pelo modelo e pelo processo de decisão.
- Entradas, desempenho e impacto serão monitorados.
- Existe plano de atualização, suspensão e reversão.
- Limitações são comunicadas a usuários e operadores.
Perguntas frequentes
Preciso dominar matemática para começar?
Não. Você pode iniciar com álgebra básica, médias, proporções e leitura de gráficos. Conforme avança, probabilidade, estatística, álgebra linear e cálculo ajudam a entender por que os algoritmos funcionam.
Aprenda a matemática junto dos problemas, sem esperar dominar todo o conteúdo antes do primeiro projeto.
É obrigatório saber programar?
Para compreender conceitos, não. Para construir projetos reproduzíveis e trabalhar na área, programação é muito importante. Python e SQL formam uma base prática. Ferramentas sem código podem validar ideias, mas não eliminam a necessidade de compreender dados, métricas e erros.
Preciso de computador potente?
Não para começar. Conjuntos tabulares pequenos e algoritmos clássicos funcionam em notebooks comuns. Ambientes hospedados executam exercícios no navegador. GPU se torna relevante em redes neurais maiores, imagens ou treinamento intensivo; não compre hardware antes de saber que seu projeto precisa.
Machine Learning ainda importa com a IA generativa?
Sim. IA generativa é construída com Machine Learning, e os fundamentos de dados, treinamento, validação, generalização e risco continuam essenciais. Além disso, previsão de demanda, fraude, recomendação e classificação tabular seguem sendo problemas centrais que não exigem um grande modelo de linguagem.
Quanto tempo leva para aprender Machine Learning?
Depende da base e do objetivo. Em algumas semanas é possível entender conceitos e concluir um projeto guiado; dominar modelagem, estatística, engenharia de dados e produção leva prática contínua. Meça progresso pela capacidade de explicar decisões e diagnosticar erros, não pelo número de cursos concluídos.
Conclusão: comece pelo problema e pelos dados
Machine Learning transforma exemplos históricos em modelos capazes de estimar resultados novos.
O processo completo inclui definir uma decisão, preparar dados, separar conjuntos, treinar, avaliar, publicar e monitorar. Algoritmo é apenas uma parte dessa cadeia.
Para começar bem, escolha um problema pequeno, crie um baseline e documente os erros.
Depois avance para ferramentas mais complexas. Um modelo simples, compreendido e monitorado costuma gerar mais valor que uma solução sofisticada construída sem dados confiáveis ou uma métrica ligada à realidade.