
Serverless: o que é, como funciona e quando vale a pena usar
Entenda o que é serverless, como a arquitetura funciona, quais são seus custos, vantagens e limitações e quando esse modelo realmente vale a pena.

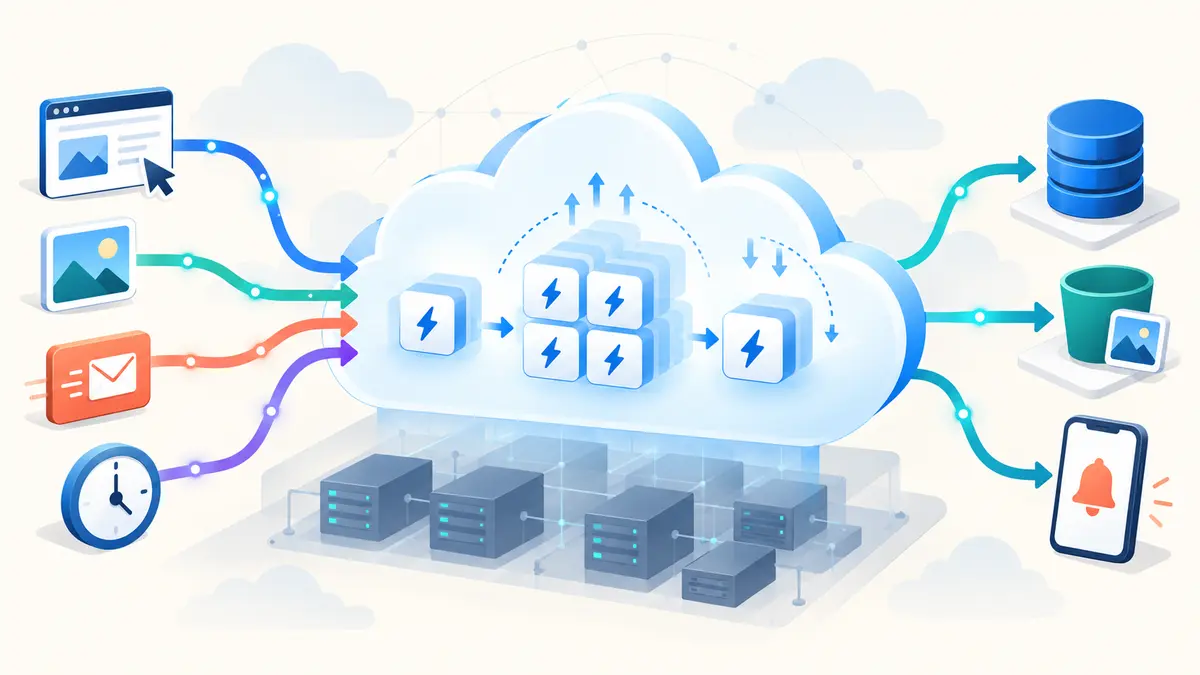
Uma aplicação recebe poucas chamadas durante a madrugada, cresce de repente após uma campanha e volta ao movimento normal algumas horas depois.
Manter servidores preparados para o pico o tempo inteiro desperdiça capacidade; dimensioná-los apenas para a média aumenta o risco de indisponibilidade.
Serverless é um modelo de computação em nuvem no qual o provedor administra a infraestrutura, o provisionamento e parte da escalabilidade, enquanto a equipe entrega código e configura os serviços necessários.
Os servidores continuam existindo, mas deixam de ser uma responsabilidade operacional direta do desenvolvedor.
Essa abordagem funciona especialmente bem para tarefas orientadas a eventos, APIs com tráfego variável, automações e processamentos assíncronos.
Não é, porém, uma solução automaticamente mais barata ou mais simples. Para entender o que é serverless de verdade, é preciso observar o ciclo de execução, os custos, o estado da aplicação e os limites impostos pela plataforma.
O que é serverless?
Serverless, ou computação sem servidor, descreve serviços de nuvem nos quais a plataforma assume tarefas como preparar máquinas, aplicar correções na infraestrutura, distribuir execuções e ajustar capacidade.
A equipe continua responsável pelo código, pelos dados, pelas permissões, pela arquitetura e pelo comportamento da aplicação.
O termo não se limita a funções. Bancos de dados, filas, armazenamento, APIs, fluxos de trabalho e contêineres também podem oferecer uma experiência serverless quando ocultam o gerenciamento dos servidores e ajustam recursos conforme a demanda.
O documento introdutório da CNCF sobre serverless organiza o modelo em torno de serviços gerenciados e execução orientada à necessidade.
Na prática, “serverless” representa uma divisão diferente de responsabilidades. A infraestrutura não desaparece; ela passa a ser operada pelo provedor e consumida por meio de uma abstração.
Serverless significa que não existem servidores?
Não. O código ainda utiliza processadores, memória, rede e armazenamento em servidores físicos.
A diferença é que a equipe não escolhe uma máquina para cada função, não instala o sistema operacional dessa máquina e normalmente não decide quando criar ou remover cada instância.
Isso reduz trabalho operacional, mas também reduz controle. O provedor define ambientes de execução, limites, regiões, formatos de implantação e parte do ciclo de vida.
Por isso, serverless não deve ser traduzido mentalmente como “infraestrutura grátis” nem “arquitetura sem operações”.
Como uma arquitetura serverless funciona?
Em um fluxo comum, um evento aciona uma unidade de código. O evento pode ser uma requisição HTTP, uma mensagem na fila, um arquivo enviado, uma alteração no banco ou um agendamento.
A plataforma prepara um ambiente de execução, entrega os dados do evento, executa o código e registra o resultado.
- Um evento acontece: por exemplo, uma imagem chega ao armazenamento.
- O gatilho é reconhecido: a plataforma associa o evento à função configurada.
- A capacidade é disponibilizada: um ambiente existente é reutilizado ou outro é inicializado.
- O código executa: a função valida a entrada, chama serviços e produz uma saída.
- A plataforma ajusta a escala: novas execuções podem ser abertas para eventos concorrentes e encerradas quando a demanda cai.
A documentação do AWS Lambda descreve esse modelo como execução de código em resposta a eventos ou chamadas de API, com gerenciamento automático de infraestrutura e escala.
Azure Functions e Cloud Run functions seguem a mesma ideia geral, embora os contratos e os limites variem.
Quais componentes formam uma aplicação serverless?
Uma função isolada raramente forma uma aplicação completa. Sistemas reais combinam serviços com responsabilidades distintas:
- Funções ou contêineres gerenciados: executam a lógica de negócio.
- API Gateway: recebe chamadas HTTP, aplica políticas e encaminha requisições.
- Filas e barramentos de eventos: desacoplam produtores e consumidores e absorvem picos.
- Banco de dados e armazenamento: preservam estado fora das execuções efêmeras.
- Orquestração: coordena etapas, esperas, compensações e falhas.
- Identidade, segredos e observabilidade: controlam acesso e tornam o sistema operável.
Esse desenho se aproxima de uma arquitetura orientada a eventos, mas os conceitos não são equivalentes.
É possível criar aplicações serverless acionadas por HTTP e também construir sistemas orientados a eventos em servidores tradicionais.
Serverless, FaaS, contêineres e máquinas virtuais
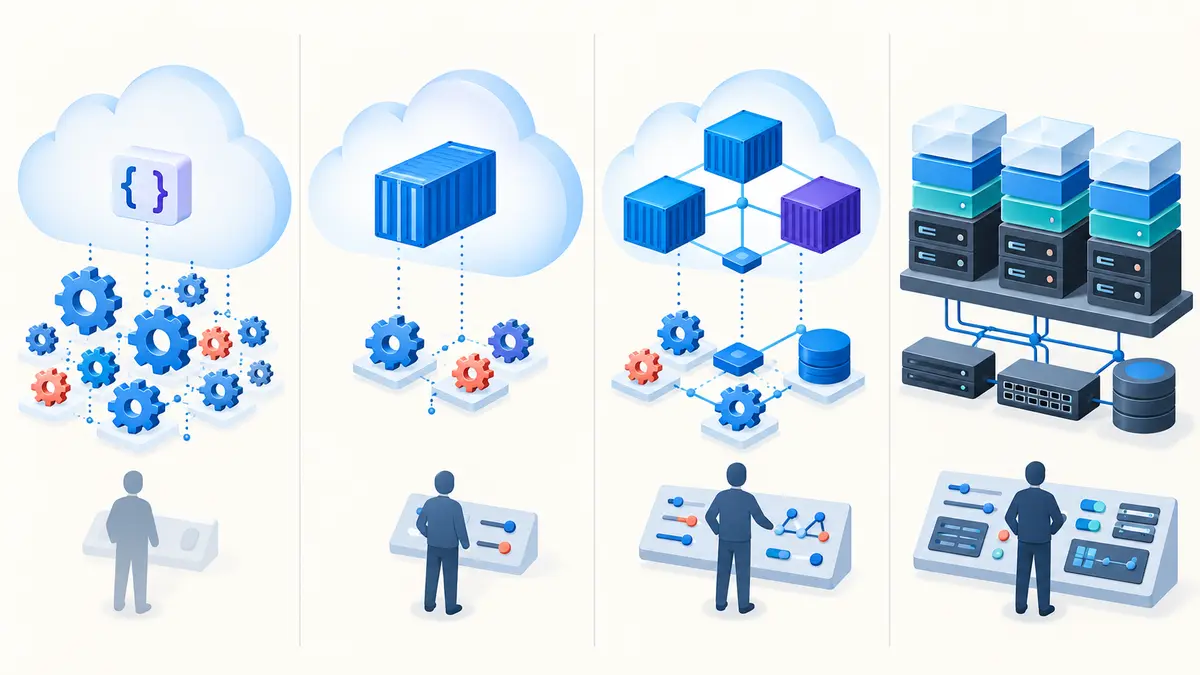
FaaS, sigla para Function as a Service, é uma forma de serverless voltada à execução de funções. Serverless é o conceito mais amplo.
Contêineres e máquinas virtuais oferecem graus crescentes de controle, mas exigem que a equipe administre mais elementos.
| Modelo | Unidade implantada | Escala e infraestrutura | Melhor encaixe |
|---|---|---|---|
| FaaS | Função e dependências | Altamente gerenciadas pelo provedor | Eventos, automações e operações curtas |
| Contêiner serverless | Imagem de contêiner | Gerenciada, com mais controle do runtime | APIs e serviços que precisam de contêiner |
| Contêiner orquestrado | Imagem, configuração e recursos | Dividida entre plataforma e equipe | Sistemas complexos e cargas persistentes |
| Máquina virtual | Sistema operacional e aplicação | Maior responsabilidade da equipe | Software legado ou necessidades específicas |
Se a aplicação precisa controlar Pods, políticas de agendamento e serviços dentro de um cluster, o artigo sobre como o Kubernetes funciona mostra o outro lado dessa escolha.
Kubernetes oferece flexibilidade, mas não elimina a operação da plataforma.
Exemplo prático de fluxo serverless
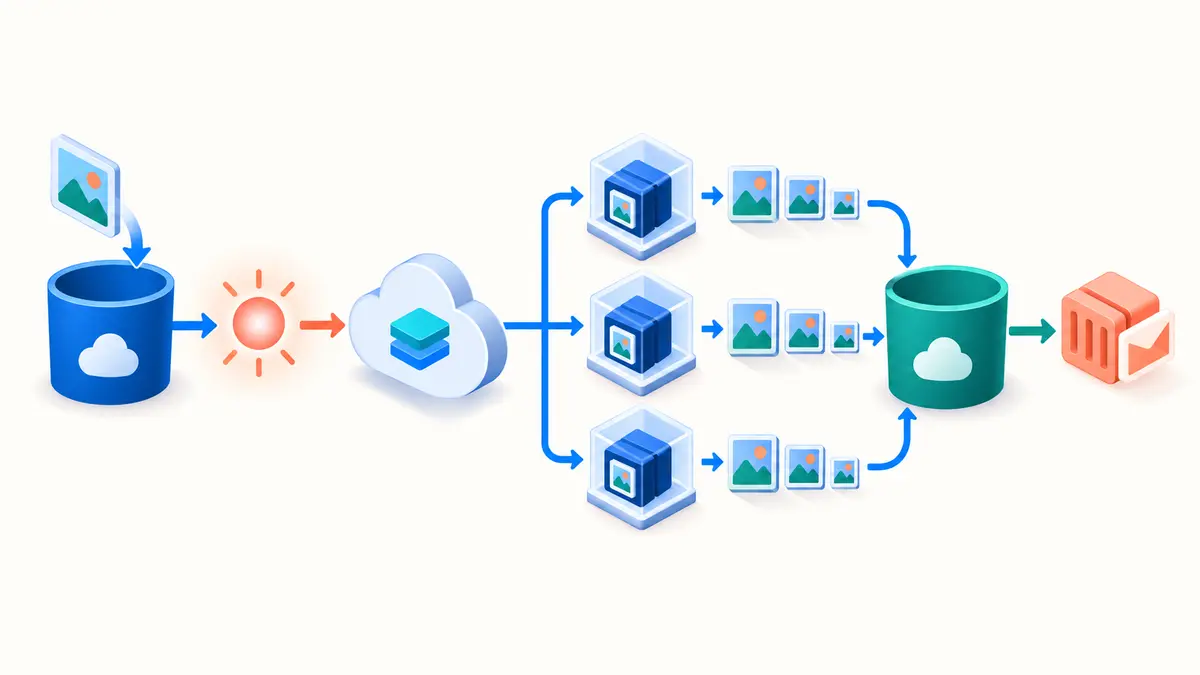
Considere um sistema que recebe fotos e cria miniaturas. O aplicativo envia o arquivo para um armazenamento de objetos.
A inclusão dispara um evento. Uma função lê a imagem, valida o formato, cria as versões menores e grava os resultados em outro local.
Ao terminar, publica uma mensagem para atualizar o catálogo.
O upload não precisa esperar todo o processamento. Uma fila de mensagens pode guardar o trabalho e controlar retentativas.
Se o evento for entregue novamente, o processamento deve reconhecer que aquela imagem já foi tratada; é nesse ponto que a idempotência evita resultados duplicados.
O mesmo padrão atende geração de documentos, envio de notificações, integração entre sistemas, tratamento de webhooks, tarefas agendadas e processamento de dados em lotes pequenos.
Vantagens do serverless
- Menos infraestrutura para administrar: o provedor cuida de servidores, capacidade e parte das atualizações.
- Escala alinhada aos eventos: a plataforma pode aumentar execuções concorrentes quando a demanda cresce.
- Custo variável: muitos serviços cobram por requisição, tempo ou recursos consumidos, reduzindo capacidade ociosa em cargas intermitentes.
- Integração com serviços gerenciados: filas, armazenamento e eventos podem acionar código sem uma camada própria de polling.
- Entrega rápida de funções específicas: equipes pequenas conseguem implantar automações sem manter um servidor dedicado.
- Isolamento de tarefas: processamentos diferentes podem escalar e falhar separadamente.
A visão geral do Azure Functions exemplifica gatilhos para uploads, tarefas agendadas, alterações de banco, APIs e filas.
Essa variedade mostra por que serverless costuma encaixar melhor quando existe um evento claro e uma unidade de trabalho bem delimitada.
Limitações e riscos
A abstração remove tarefas, mas não remove decisões. Uma aplicação com dezenas de funções pode espalhar lógica, permissões, filas e configurações por muitos recursos.
Sem padrões de arquitetura e automação de infraestrutura, pequenas unidades viram um sistema difícil de compreender.
- Cold start: inicializações podem acrescentar latência.
- Limites da plataforma: duração, memória, tamanho de pacote, concorrência e rede variam por serviço.
- Dependência do provedor: gatilhos, permissões e observabilidade podem usar contratos específicos.
- Testes locais incompletos: reproduzir eventos e integrações da nuvem exige ferramentas e ambientes de teste.
- Custos distribuídos: a função pode ser barata enquanto logs, filas, gateways, tráfego e banco elevam a conta.
- Depuração entre serviços: uma operação pode atravessar vários eventos antes de terminar.
A solução não é evitar todo serviço proprietário. É conhecer o acoplamento e decidir onde ele gera valor.
Um gatilho específico pode simplificar muito a aplicação; em outro cenário, um protocolo aberto e um contêiner portátil podem reduzir risco de migração.
O que é cold start?
Cold start é o trabalho de inicializar um ambiente antes da execução: obter o código, iniciar o runtime, carregar dependências e executar configurações iniciais.
Quando um ambiente já preparado pode ser reutilizado, a chamada é considerada “quente” e tende a começar mais rápido.
A documentação do ciclo de execução do AWS Lambda mostra as fases de inicialização, invocação e encerramento e explica como a preparação acrescenta latência à primeira chamada daquele ambiente.
O impacto depende do runtime, do tamanho do pacote, das bibliotecas, da configuração de rede e do padrão de tráfego.
Reduzir dependências e trabalho feito fora do manipulador ajuda, mas aplicações com exigência rígida de latência podem precisar de capacidade pré-inicializada ou de outro modelo de execução.
Nesse caso, parte da economia de escalar a zero pode desaparecer.
Estado, banco de dados e concorrência
Funções devem ser tratadas como efêmeras. Um ambiente pode ser reutilizado, mas a aplicação não deve depender de memória ou disco local para preservar dados importantes entre chamadas.
Estado durável pertence a bancos, armazenamento ou serviços próprios para essa finalidade.
A escala rápida também pode pressionar dependências. Se centenas de execuções abrirem conexões simultâneas com um banco relacional, a função escala antes do banco.
Pooling compatível, proxies de conexão, limites de concorrência e filas protegem o recurso mais lento.
Eventos assíncronos podem ser repetidos depois de falhas ou timeouts. Operações de cobrança, criação de pedidos e envio de mensagens precisam de deduplicação, idempotência e uma estratégia clara para tentativas esgotadas.
Como funcionam os custos
Em FaaS, a cobrança normalmente considera quantidade de invocações e recursos usados durante a execução.
Outros componentes têm métricas próprias: operações no armazenamento, mensagens, chamadas ao gateway, duração de fluxos, retenção de logs e transferência de dados.
Cargas esporádicas tendem a aproveitar melhor o modelo variável. Uma automação executada algumas vezes por dia não precisa de servidor ocioso.
Já um serviço com uso alto e constante pode ter custo previsível menor em contêineres ou máquinas reservadas, dependendo da equipe e da plataforma.
A comparação correta inclui custo de infraestrutura, engenharia, plantão, atualizações, tempo de entrega e risco operacional.
Olhar apenas o preço de uma função ignora tanto serviços auxiliares quanto o trabalho que deixou de ser feito pela equipe.
Segurança e observabilidade
O provedor protege a infraestrutura gerenciada; a equipe ainda precisa configurar permissões mínimas, validar entradas, atualizar dependências e limitar o acesso aos dados.
Cada função deve receber apenas as autorizações necessárias. Credenciais não devem ser colocadas no código ou em variáveis distribuídas manualmente: um processo de gerenciamento de segredos reduz exposição e facilita rotação.
Na operação, logs isolados não explicam uma jornada assíncrona. Inclua identificadores de correlação, métricas de duração e erro, profundidade de filas, tentativas, descartes e tracing distribuído.
A instrumentação com OpenTelemetry ajuda a acompanhar uma transação entre funções e serviços sem depender apenas do console de um fornecedor.
Controle de custo também faz parte da observabilidade. Alarmes de orçamento, limites de concorrência e detecção de loops impedem que um erro de evento produza milhões de execuções antes de ser percebido.
Quando serverless vale a pena?
Serverless costuma trazer bom retorno quando o trabalho é curto, independente, orientado a eventos e apresenta tráfego variável. Alguns exemplos:
- webhooks e integrações entre sistemas;
- tarefas agendadas e rotinas de limpeza;
- processamento de arquivos após upload;
- consumidores de filas e eventos;
- APIs pequenas ou com demanda irregular;
- protótipos e produtos em validação;
- automações internas sem necessidade de servidor permanente;
- pipelines de dados acionados por chegada de informações.
A documentação do Cloud Run functions apresenta funções acionadas por HTTP e eventos de serviços da nuvem.
Esse é o encaixe mais natural: a plataforma reage a algo observável e executa uma tarefa com começo e fim.
Quando serverless pode não ser a melhor escolha?
Cargas contínuas, previsíveis e intensivas podem aproveitar melhor recursos dedicados.
O mesmo vale para processos muito longos, sistemas que precisam de controle fino do sistema operacional, aplicações dependentes de armazenamento local ou serviços com latência extremamente previsível.
Outro sinal de alerta aparece quando quase toda a lógica precisa contornar limites da plataforma.
Se a equipe mantém aquecimento artificial, divide um processo natural em muitas funções, cria camadas para simular estado local e paga capacidade constante, talvez um contêiner gerenciado entregue simplicidade maior.
Também não faz sentido adotar serverless apenas por tendência. Uma aplicação pequena e estável já hospedada com baixo custo pode não justificar migração, novos serviços e uma mudança completa na forma de observar falhas.
Como avaliar antes de adotar
- Descreva a carga: frequência, duração, concorrência, tamanho dos dados e exigência de latência.
- Mapeie os gatilhos: HTTP, eventos, filas, arquivos ou agendamentos.
- Identifique estado e dependências: banco, conexões, arquivos temporários e serviços externos.
- Calcule o sistema completo: funções, gateways, filas, logs, tráfego e operação humana.
- Teste limites e falhas: cold start, timeouts, duplicidade, retentativas e indisponibilidade regional.
- Avalie portabilidade: quais partes usam APIs específicas e qual seria o custo real de migração.
- Comece por um fluxo delimitado: uma automação ou consumidor de eventos oferece aprendizado sem migrar toda a aplicação.
Se o fluxo começa por HTTP, um API Gateway pode concentrar autenticação, roteamento e limites.
Ainda assim, ele adiciona custo e outra dependência; deve entrar porque resolve um problema concreto.
Perguntas frequentes
Serverless é gratuito quando não há uso?
Nem sempre. Alguns componentes podem escalar a zero, mas armazenamento, bancos, endereços de rede, logs e capacidade pré-inicializada podem gerar cobrança mesmo sem invocações. Consulte todos os serviços da arquitetura.
AWS Lambda é sinônimo de serverless?
Não. AWS Lambda é um serviço de computação serverless. Azure Functions, Cloud Run functions, contêineres gerenciados, bancos e filas serverless são outras implementações do modelo.
Serverless substitui microsserviços?
Não. Microsserviços tratam da divisão do sistema por responsabilidades; serverless trata principalmente do modelo de execução e operação. Um microsserviço pode rodar em funções, contêineres ou máquinas virtuais.
Uma aplicação serverless precisa ser stateless?
A execução deve evitar depender de estado local persistente. A aplicação como um todo pode ter estado, desde que ele seja armazenado em bancos, objetos ou serviços duráveis externos à função.
Serverless serve para APIs?
Sim, principalmente quando a demanda é variável e as operações cabem nos limites da plataforma. APIs com conexões longas, tráfego constante ou latência rígida precisam de avaliação mais cuidadosa.
Como reduzir dependência de fornecedor?
Isole integrações proprietárias, automatize infraestrutura, mantenha regras de negócio separadas dos gatilhos e use formatos abertos quando houver benefício real. Portabilidade total tem custo e nem sempre é o melhor objetivo.
Conclusão
Serverless troca o gerenciamento direto de servidores por serviços gerenciados, escala orientada à demanda e cobrança baseada em consumo.
O ganho aparece quando a carga se encaixa no modelo e a equipe projeta eventos, estado, segurança e observabilidade desde o início.
Para decidir quando vale a pena usar, compare o fluxo completo — não apenas a função.
Começar por uma tarefa bem delimitada permite medir latência, custo e complexidade antes de comprometer toda a arquitetura.