
Rate Limiting em APIs: como limitar requisições e evitar abusos
Entenda como funciona o rate limiting em APIs, conheça os principais algoritmos e aprenda a definir limites sem bloquear usuários legítimos.

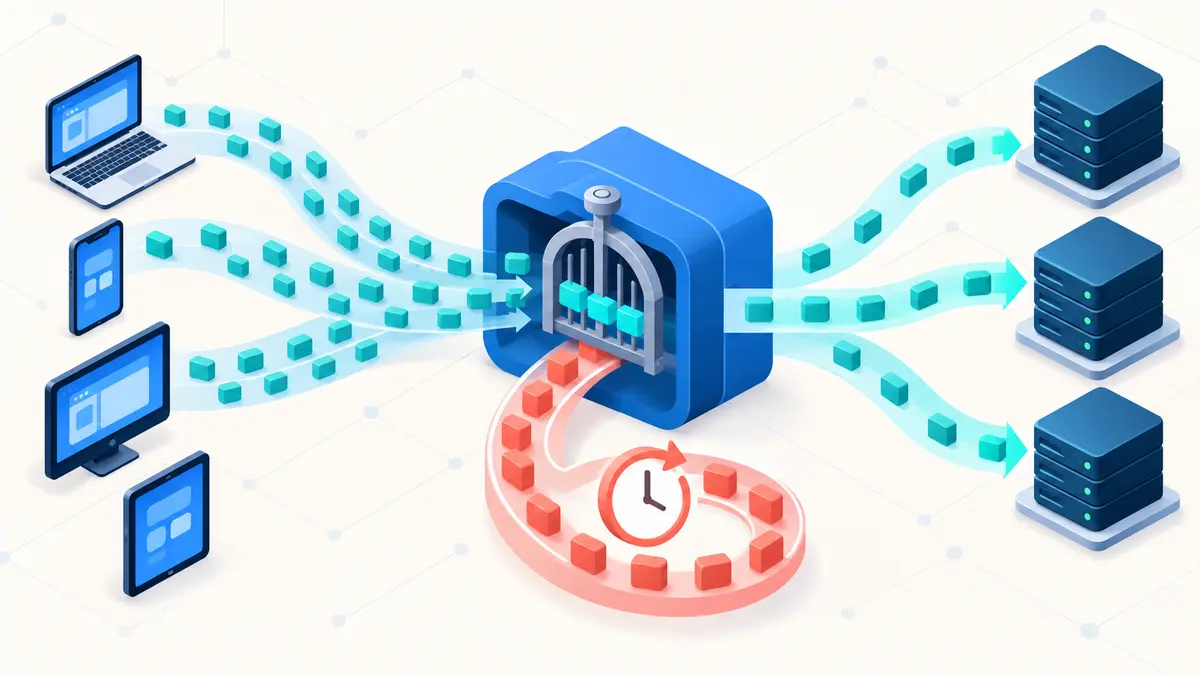
Uma API pode funcionar bem durante meses e, de repente, receber milhares de chamadas em poucos segundos.
O motivo pode ser um cliente com erro de repetição, uma integração mal configurada, uma campanha que gerou tráfego legítimo ou uma tentativa deliberada de abuso.
Sem controle, todos esses cenários disputam os mesmos recursos do servidor.
Rate limiting em APIs é o mecanismo que restringe quantas requisições um cliente pode fazer dentro de um intervalo ou de uma taxa definida.
Quando aplicado corretamente, ele preserva capacidade, distribui o acesso com mais justiça e impede que um consumidor prejudique os demais.
O desafio não está apenas em escolher um número, como “cem chamadas por minuto”.
É preciso definir quem será limitado, quais rotas custam mais, como lidar com picos legítimos, onde guardar os contadores e o que o cliente deve fazer ao receber uma recusa.
Este guia organiza essas decisões sem tratar o limitador como uma solução isolada para segurança ou escalabilidade.
O que é rate limiting em APIs?
Rate limiting, ou limitação de taxa, é uma política de controle de tráfego. O servidor acompanha as chamadas atribuídas a uma identidade e decide se a próxima requisição ainda cabe na regra.
Essa identidade pode ser um usuário autenticado, uma chave de API, uma aplicação, um endereço IP ou uma combinação desses elementos.
Imagine uma API de geração de relatórios. Consultar um relatório pronto quase não consome recursos, mas gerar um arquivo com milhões de registros pode ocupar CPU, memória e banco de dados por vários segundos. Aplicar a mesma regra às duas rotas ignora o custo real.
Um bom projeto limita não só a frequência, mas também considera o peso da operação.
Esse controle complementa autenticação, autorização, validação e outras boas práticas para criar APIs seguras e escaláveis. Ele reduz abuso e sobrecarga, mas não verifica se o usuário tem permissão nem corrige consultas lentas.
Como o rate limiting funciona
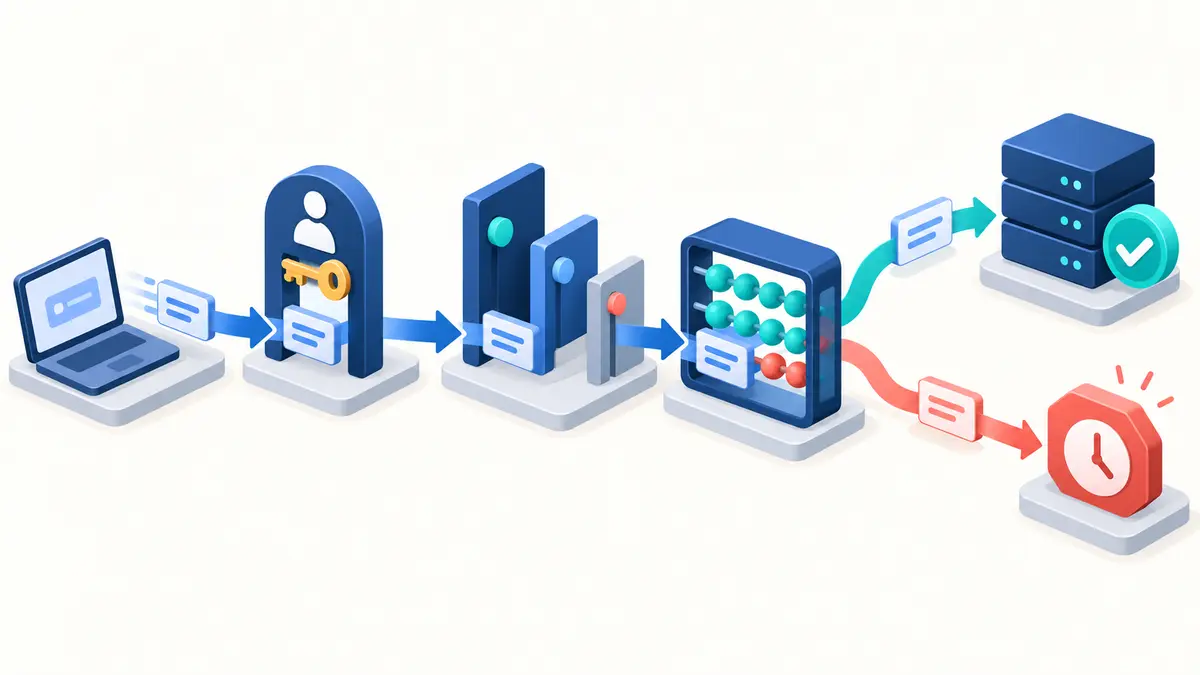
Em uma implementação simples, cada requisição passa por quatro decisões. O sistema identifica o consumidor, encontra a política aplicável, consulta ou atualiza o estado do limitador e permite, atrasa ou recusa a chamada.
- Identificação: uma chave representa o consumidor e, quando necessário, a rota ou o tipo de operação.
- Contagem: o limitador registra chamadas, tokens ou unidades de custo dentro da regra.
- Decisão: a requisição segue quando há capacidade disponível; caso contrário, recebe uma resposta de limite excedido ou entra em espera controlada.
- Comunicação: a API informa o motivo e, quando possível, o momento adequado para uma nova tentativa.
Considere uma política de dez requisições por segundo com uma pequena tolerância para picos. Um aplicativo que envia três chamadas quase simultâneas pode ser atendido normalmente.
Um processo com erro que dispara centenas de chamadas encontra o limite antes de ocupar toda a capacidade do backend.
Rate limiting, throttling e quota são iguais?
Os termos aparecem como sinônimos em muitas plataformas, mas podem representar comportamentos diferentes. Por isso, a documentação da própria API deve ser a referência final.
| Conceito | Uso mais comum | Exemplo |
|---|---|---|
| Rate limiting | Controlar a frequência de chamadas | Até 20 requisições por segundo por chave |
| Throttling | Reduzir, atrasar ou rejeitar tráfego acima da capacidade | Absorver um pico curto e recusar o excedente |
| Quota | Definir uma franquia acumulada em período maior | Um milhão de operações por mês |
| Concorrência | Limitar quantas operações ficam ativas ao mesmo tempo | Até cinco relatórios sendo gerados por conta |
Uma API pode combinar todas essas regras. Um cliente recebe uma taxa por segundo, uma quota mensal e um teto de operações simultâneas.
A combinação protege tanto contra rajadas quanto contra uso acumulado além do plano contratado.
Principais algoritmos de rate limiting
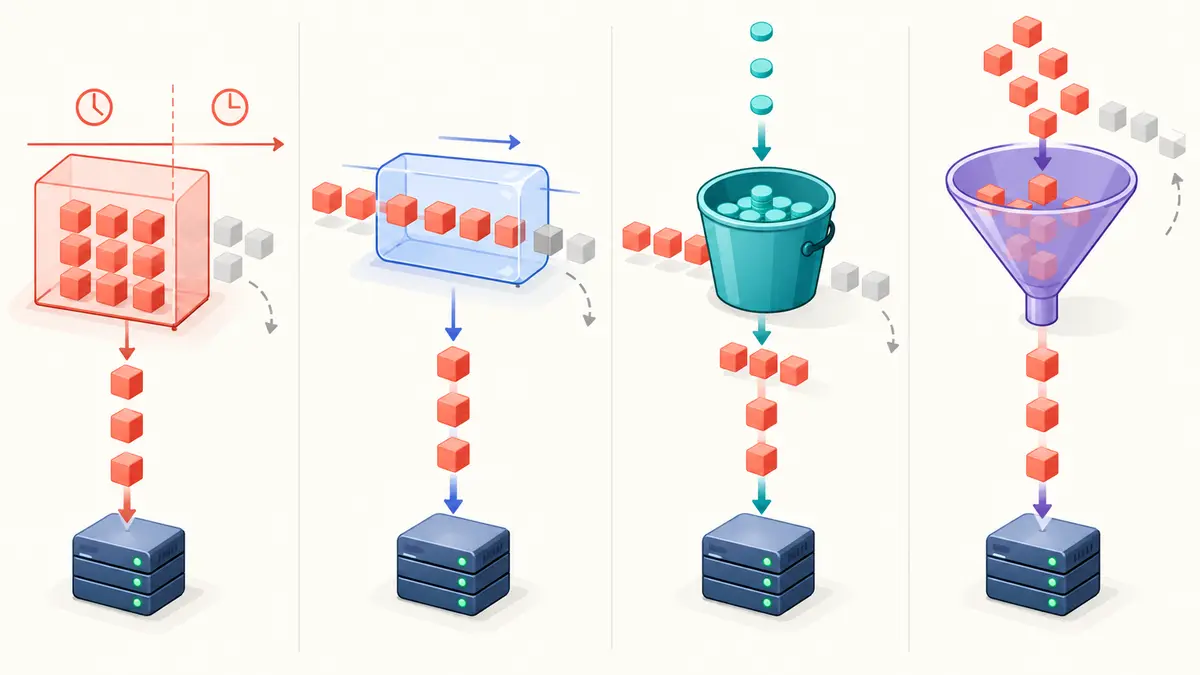
O algoritmo determina como o sistema mede o tráfego e reage aos picos. Não existe uma opção universalmente melhor: precisão, memória, custo de coordenação e tolerância a rajadas puxam a decisão em direções diferentes.
| Algoritmo | Como funciona | Vantagem | Limitação |
|---|---|---|---|
| Janela fixa | Conta chamadas em blocos fechados de tempo | Simples e barato | Pode aceitar dois picos próximos à troca da janela |
| Janela deslizante | Considera o período imediatamente anterior a cada chamada | Controle mais uniforme | Exige mais estado ou aproximação |
| Token bucket | Tokens são repostos continuamente e gastos pelas chamadas | Aceita rajadas curtas sem perder a taxa média | Precisa configurar taxa e capacidade do balde |
| Leaky bucket | Escoa trabalho em ritmo controlado | Suaviza a entrada para o backend | Pode adicionar espera e latência |
A documentação do Redis sobre limitadores de requisições reúne implementações de janela fixa, janela deslizante e token bucket.
O armazenamento rápido e as operações atômicas tornam o Redis uma escolha frequente quando várias instâncias precisam compartilhar contadores.
Qual algoritmo escolher?
Para uma API interna de baixo risco, uma janela fixa pode entregar o controle necessário com pouca complexidade.
Se o produto precisa aceitar cliques simultâneos, carregamento paralelo de telas ou sincronizações em lote, token bucket costuma lidar melhor com rajadas legítimas.
Operações caras, como exportações, podem exigir limite de concorrência além da taxa.
A pergunta prática é: qual padrão de uso o sistema deve permitir? Escolher primeiro o comportamento desejado evita transformar o nome do algoritmo em uma decisão arquitetural automática.
O que deve identificar o cliente
Limitar apenas por endereço IP parece conveniente, porém pode gerar injustiça.
Uma empresa inteira pode sair para a internet pelo mesmo endereço, enquanto um atacante consegue distribuir chamadas entre muitos IPs.
Em ambientes com proxies, usar o cabeçalho de origem sem validar a cadeia confiável também permite falsificação.
Quando existe autenticação, identificadores como usuário, organização, aplicação OAuth ou chave de API costumam representar melhor o consumidor. Ainda assim, uma proteção inicial por IP pode ser útil antes do login. Rotas sensíveis podem combinar dimensões: tentativas por conta e IP no login, por exemplo.
A chave do limitador não deve expor tokens ou dados pessoais em logs e métricas. Prefira um identificador interno ou um hash apropriado, com política de retenção coerente.
Onde aplicar o limite
O controle pode existir em mais de uma camada. CDN ou proteção de borda bloqueia padrões volumosos antes que cheguem à infraestrutura. Um proxy reverso ou gateway aplica políticas gerais.
A aplicação, por conhecer usuário, plano e custo da operação, consegue definir regras mais específicas.
Centralizar políticas comuns em um API Gateway reduz duplicação entre serviços, mas não elimina limites no domínio. Uma rota de pagamento ou exportação pode precisar de regras que o gateway não entende sozinho.
Em arquiteturas com várias instâncias, o balanceamento de carga cria outra preocupação: se cada servidor mantiver seu próprio contador, o limite efetivo cresce conforme novas instâncias são adicionadas. Para uma política global, o estado precisa ser compartilhado ou particionado de forma previsível.
Como responder quando o limite é excedido
Para HTTP, a resposta mais clara é 429 Too Many Requests. A RFC 6585, que define o código 429, recomenda explicar a condição e permite enviar o cabeçalho Retry-After para indicar quanto tempo o cliente deve esperar.
HTTP/1.1 429 Too Many Requests
Content-Type: application/json
Retry-After: 30

{
  "error": "rate_limit_exceeded",
  "message": "Tente novamente em 30 segundos."
}
Algumas APIs também informam limite, saldo e reinício por cabeçalhos próprios. Há uma proposta ativa do IETF para padronizar campos HTTP de rate limiting, mas ela continua como Internet-Draft. Portanto, em 2026, clientes não devem pressupor um formato universal: o contrato da API ainda precisa documentar nomes e semântica.
O cliente deve respeitar Retry-After e evitar retentativas agressivas. Backoff exponencial com aleatoriedade, conhecido como jitter, reduz a chance de milhares de instâncias voltarem exatamente no mesmo momento. Em operações de escrita, retentar também exige cuidado com duplicidade; o guia de idempotência em APIs explica como preservar o efeito correto.
Exemplo de rate limiting no NGINX
O módulo ngx_http_limit_req_module do NGINX limita a taxa por uma chave e usa o método leaky bucket. O exemplo abaixo cria uma zona compartilhada por IP, mantém uma taxa média de dez requisições por segundo e aceita uma rajada curta.
http {
    limit_req_zone $binary_remote_addr zone=api_por_ip:10m rate=10r/s;

    server {
        location /api/ {
            limit_req zone=api_por_ip burst=20 nodelay;
            limit_req_status 429;
            proxy_pass http://backend;
        }
    }
}
Segundo a documentação oficial do módulo de limitação do NGINX, burst define a tolerância ao excedente e nodelay evita colocar as chamadas excedentes aceitas em espera. Sem nodelay, parte do tráfego pode ser atrasada para respeitar o ritmo configurado.
Esse trecho é um ponto de partida, não uma configuração pronta para qualquer produção. É preciso validar quais IPs chegam ao NGINX, como proxies confiáveis são tratados, quais rotas terão a regra e quanto tráfego legítimo aparece nos picos.
Rate limiting em sistemas distribuídos
Um contador em memória funciona em uma única instância. Ao escalar horizontalmente, duas chamadas do mesmo cliente podem chegar a servidores diferentes e consultar estados distintos. O sistema passa a permitir mais tráfego do que a política promete.
Uma saída é armazenar o estado em um serviço compartilhado, como Redis, usando operações atômicas e expiração. Outra é fazer o controle no gateway que recebe todas as chamadas. Em escala muito alta, o projeto pode preferir limites aproximados e estado regional para reduzir latência e dependência central.
Também é necessário decidir o comportamento em caso de falha do limitador. Fail-open permite chamadas quando o serviço de contagem está indisponível, preservando disponibilidade, porém reduzindo proteção. Fail-closed bloqueia, protegendo recursos críticos, mas pode causar indisponibilidade mesmo quando o backend está saudável. A escolha deve variar conforme o risco da rota.
Como definir limites sem prejudicar usuários
Limites arbitrários costumam falhar nos dois extremos: frouxos demais para proteger ou rígidos demais para o uso normal. O ponto inicial deve vir de capacidade medida e comportamento real.
- Separe leituras baratas de escritas e operações pesadas.
- Observe percentis de tráfego por usuário, aplicação e rota.
- Reserve margem para picos legítimos, implantações e sincronizações.
- Defina políticas diferentes por plano somente quando o produto realmente oferecer essa distinção.
- Teste a degradação e a recuperação, não apenas o caminho aceito.
- Comunique limites na documentação antes de aplicá-los.
Serviços gerenciados também separam taxa sustentada e rajada. A documentação de throttling do Amazon API Gateway, por exemplo, expõe configurações de taxa e burst para rotas. O princípio é útil mesmo fora da AWS: atender um pico curto pode ser aceitável, desde que a média não pressione o backend continuamente.
Rate limiting impede ataques DDoS?
Não sozinho. Um limitador na aplicação reduz abuso de rotas e protege recursos internos, mas um ataque distribuído pode saturar rede, conexões ou infraestrutura antes que a chamada alcance essa camada. Nesse caso, responder a cada tentativa também consome capacidade.
A proteção costuma combinar CDN, mitigação de DDoS, firewall de aplicação, limites na borda, autenticação, filas, cache e capacidade de absorção. O rate limiting continua valioso, mas deve ser tratado como uma camada de defesa e controle de consumo, não como substituto de uma estratégia completa.
Observabilidade e métricas essenciais
Uma política que ninguém observa vira uma caixa-preta. Registre o total de chamadas aceitas, atrasadas e recusadas; a rota e a política acionada; a latência do armazenamento de estado; e a quantidade de clientes afetados. Evite colocar chaves, tokens e identificadores pessoais diretamente nos rótulos das métricas.
Alertas devem considerar proporção e contexto. Dez respostas 429 podem ser normais em uma API pública; um aumento repentino em rota crítica pode indicar cliente com defeito ou ataque.
Correlacionar métricas, logs e traces por meio de uma estratégia de observabilidade com OpenTelemetry ajuda a descobrir se o limite protegeu o backend ou apenas mascarou outro gargalo.
Erros comuns ao implementar rate limiting
- Usar somente IP: prejudica redes compartilhadas e é fácil de contornar em ataques distribuídos.
- Aplicar um número global a todas as rotas: ignora diferenças de custo e criticidade.
- Guardar contadores apenas na instância: torna o limite inconsistente quando a aplicação escala.
- Retornar erro genérico: impede o cliente de distinguir limite, autenticação e falha interna.
- Não orientar a nova tentativa: estimula loops agressivos e novos picos.
- Confiar no limitador como segurança completa: deixa lacunas de autenticação, autorização e proteção de borda.
- Ativar em produção sem observar: pode bloquear usuários reais sem que a equipe perceba.
Checklist de implementação
- Mapeie rotas, custos e padrões legítimos de uso.
- Escolha a identidade correta para cada camada.
- Defina taxa sustentada, tolerância a rajada e, se necessário, quota e concorrência.
- Selecione o algoritmo compatível com o comportamento desejado.
- Garanta atomicidade e consistência suficientes para a arquitetura.
- Retorne 429 com corpo claro e
Retry-Afterquando aplicável. - Documente a política para os consumidores.
- Implemente retentativas com backoff e jitter nos clientes controlados pela equipe.
- Monitore recusas, latência, falhas do armazenamento e impacto no backend.
- Comece em modo de observação ou com limites conservadores e ajuste com dados.
Perguntas frequentes
Qual status HTTP usar quando o limite é excedido?
Use 429 Too Many Requests quando a recusa ocorre porque o cliente ultrapassou a taxa permitida. Inclua uma mensagem clara e, quando souber o tempo de espera, envie Retry-After.
Rate limiting por IP é suficiente?
Raramente como única regra. IP é útil como proteção inicial, mas redes compartilhadas concentram usuários no mesmo endereço e ataques distribuídos usam muitos endereços. Combine-o com identidade autenticada quando possível.
Onde guardar os contadores?
Em uma instância única, a memória local pode bastar. Em sistemas distribuídos que exigem um limite global, use estado compartilhado, gateway central ou outra estratégia coordenada.
Redis é comum, mas precisa de atomicidade, expiração, disponibilidade e monitoramento.
O limite deve ser por usuário ou por rota?
Frequentemente pelos dois. A identidade distribui o consumo entre clientes, enquanto a rota representa custo e risco.
Uma política composta evita que uma operação pesada receba o mesmo tratamento de uma leitura simples.
Rate limiting substitui cache ou escalabilidade?
Não. O limitador controla entrada; cache reduz trabalho repetido e escalabilidade aumenta capacidade.
Se uma requisição legítima continua cara, apenas bloqueá-la mais cedo não resolve a causa do custo.
Como testar o rate limiting?
Teste abaixo, na borda e acima do limite; rajadas; troca de janela; chamadas concorrentes; múltiplas instâncias; expiração dos contadores; falha do armazenamento; cabeçalhos e tempo de recuperação.
Verifique também se clientes legítimos conseguem se adaptar à resposta 429.
Conclusão
Rate limiting em APIs funciona bem quando transforma capacidade técnica e regras de produto em uma política compreensível.
Isso exige mais do que um contador: identidade correta, algoritmo adequado, estado coerente, resposta 429 útil e métricas para ajustar o comportamento.
Comece pelas rotas mais caras ou expostas, observe o tráfego antes de bloquear e trate rajadas legítimas de forma diferente de abuso contínuo. Assim, o limite protege o serviço sem virar um obstáculo invisível para quem usa a API corretamente.