
Como rodar IA localmente com Ollama: guia prático para iniciantes
Guia para instalar o Ollama, executar um modelo local e entender requisitos, privacidade, desempenho e limitações.

Usar um assistente de IA sem enviar cada prompt para um serviço externo é possível.
Com o Ollama, você baixa modelos compatíveis e os executa no próprio computador por terminal e API local.
Rodar IA localmente com Ollama pode aumentar controle sobre dados e permitir testes offline depois do download.
Em troca, você assume limites do hardware, armazenamento, atualizações e segurança. Local não significa automaticamente privado.
Este guia mostra o caminho inicial, explica como escolher um modelo e ajuda a decidir quando a solução local compensa.
O que é Ollama?
Ollama é uma ferramenta para baixar, executar e gerenciar modelos em macOS, Windows e Linux.
Ela oferece comandos simples e API local. A documentação oficial de início rápido apresenta instalação e execução.
Vantagens e limitações: rodar IA localmente com Ollama
- maior controle sobre onde prompts são processados;
- funcionamento sem internet após os downloads;
- custo previsível para testes recorrentes;
- integração por API local.
Limitações incluem memória, velocidade, modelos menores e responsabilidade por proteção.
Para dados sensíveis, verifique interfaces, telemetria, logs e backups. Consulte também como proteger dados ao usar IA.
Quais são os requisitos de hardware?
Não existe configuração universal. Tamanho, quantização, contexto e velocidade alteram memória e processamento.
Modelos compactos rodam em CPU, mas GPU compatível costuma acelerar a geração.
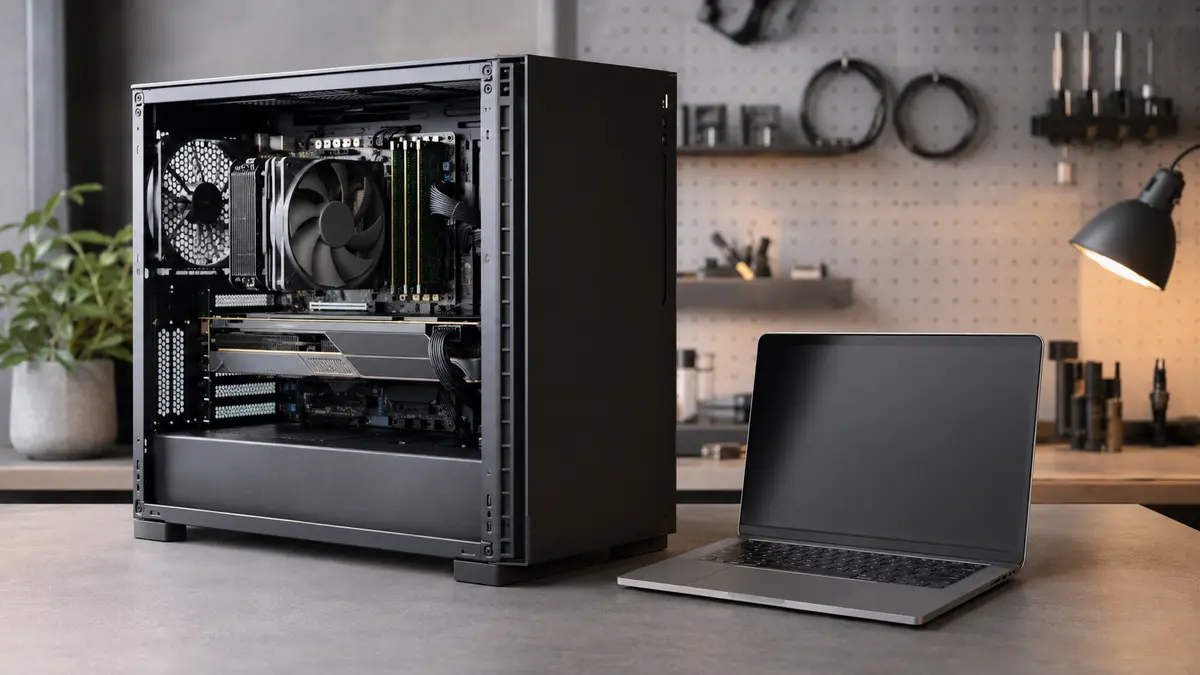
A página de suporte de hardware do Ollama mantém requisitos atuais. Consulte-a antes de comprar componentes.
Memória disponível importa mais do que olhar apenas o nome comercial.
Como instalar o Ollama
- acesse a página oficial;
- escolha o instalador do sistema;
- conclua as permissões apresentadas;
- abra terminal ou PowerShell;
- confirme que o comando
ollamaresponde.
Evite instaladores de sites desconhecidos. Em máquinas de trabalho, confirme a política da empresa.
Como escolher um modelo local
Comece pela tarefa. Um modelo pequeno pode bastar para classificação, resumo e rascunhos.
Código, raciocínio complexo, contexto longo e português de alta qualidade podem exigir modelos maiores.
- tamanho e memória;
- idiomas e tarefas;
- licença;
- limite de contexto;
- origem e manutenção;
- qualidade nos seus exemplos.
Use a biblioteca oficial de modelos para consultar variantes. Leia a licença original.
Executando o primeiro modelo
A forma geral é ollama run nome-do-modelo. Na primeira vez, os arquivos são baixados; depois abre uma sessão interativa.
Use o identificador exato indicado na biblioteca.
Teste uma pergunta conhecida, um resumo não sensível e uma tarefa específica.
Observe tempo, velocidade, memória e qualidade. Não avalie apenas uma conversa impressionante.
Como usar a API local
O Ollama disponibiliza API para aplicações. Confira endereço, porta, autenticação e exposição de rede na documentação da versão.
Uma API acessível além do computador pode permitir uso indevido.
Trate o serviço como backend: valide entrada, limite tamanho, configure timeout, registre erros sem dados sensíveis e não exponha a porta diretamente à internet.
IA local é realmente privada?
Processamento local reduz o envio ao provedor de inferência, mas privacidade depende do fluxo inteiro.
Interface web, extensão, busca, sistema operacional, backups e logs podem transmitir ou guardar cópias.
- baixe de fontes verificadas;
- controle usuários e permissões;
- não exponha API sem proteção;
- revise integrações de internet e arquivos;
- cripte discos quando necessário;
- trate dados pessoais com finalidade adequada.
Ollama ou IA na nuvem?
Use local quando controle, offline e volume recorrente pesarem mais que conveniência.
Prefira nuvem para modelos maiores, alta disponibilidade e manutenção reduzida. Uma arquitetura híbrida também é possível.
Erros comuns ao começar
- baixar o maior modelo sem verificar memória;
- avaliar com apenas um prompt;
- confundir local com anonimato;
- abrir API para a rede inteira;
- ignorar licença e origem;
- esperar a mesma velocidade da nuvem.
Executar um modelo não é o mesmo que treiná-lo. Para entender a outra etapa, veja o guia de machine learning com Python.
Também vale comparar as limitações da inteligência artificial e aplicar princípios de IA responsável mesmo quando o processamento ocorre localmente.
Perguntas frequentes
O Ollama funciona sem internet?
Sim, depois que software e modelo estiverem instalados. Integrações externas ainda dependem de conexão.
Precisa de GPU?
Nem sempre. Alguns modelos rodam em CPU, mas GPU compatível melhora a velocidade.
Ollama é gratuito?
A ferramenta tem distribuição própria, mas cada modelo possui licença e o hardware gera custos.
Os dados nunca saem do computador?
Não é possível garantir olhando só o Ollama. Audite interface, plugins, sistema, logs e rede.
Qual modelo baixar primeiro?
Escolha uma variante pequena que caiba com folga na memória e teste tarefas reais antes de aumentar.
Conclusão
Ollama torna a IA local mais acessível, mas não elimina decisões técnicas. Comece pequeno, meça desempenho, valide privacidade ponta a ponta e proteja a API.